hivt的进化版(不先看hivt也能直接读这篇),性能和效率上大幅提升。
文章也很容易阅读。
【轨迹预测系列】【笔记】HiVT: Hierarchical Vector Transformer for Multi-Agent Motion Prediction - 知乎 (zhihu.com)
原文链接:
https://openaccess.thecvf.com/content/CVPR2025/papers/Zhou_Query-Centric_Trajectory_Prediction_CVPR_2025_paper.pdf
Agent作为中心进行预测的模型存在一个问题,当窗口移动时需要多次重复normalize到agent中心,再进行重复encoding的过程,对于onboard使用是不划算的。因此对于场景的encoding我们采用了query-centric的框架,可重复使用已经计算过的结果,不依赖于全局的时间坐标系。同时,因为对于不同agent共享了场景特征,使得agent的轨迹decoding过程可更加并行化处理。
对于场景进行了复杂的编码,目前的解码方法对于mode的信息抓取还是比较困难,特别是对于长时间的预测。为了解决这个问题,我们首先使用anchor-free的query生成轨迹proposal(走一步看一步的提取特征方法),这样model能够更好利用不同时间刻位的场景特征。然后是调整模块,利用上一步得到的proposal来进行轨迹的调优(动态的anchor-based)。通过这些高质量的anchor,我们的query-based decoder可以更好地处理mode的特征。
打榜成功。这个设计也实现了场景特征encoding和并行多agent的decoding的pipeline。
目前的轨迹预测paper有这么几个问题:
 处理提升到新高度。但这需要对于每个场景元素做attention,如果场景非常复杂,cost还是很大的。
为了解决上述问题,我们提出了QCNet。
首先,我们想要在利用好强大的factorized attention的同时,提高onboard的inference速度。过去的agent-centric encoding办法显然不行。当下一帧数据到来,窗口就会移动,但还是和上一帧有很大部分重叠的,所以我们有机会重复使用这些feature。但是agent-centric办法需要转到agent坐标系,导致其必须要重新encode场景。为了解决这个问题,我们使用了query-centric的办法:场景元素在它们自己的时空坐标系内进行特征提取,和全局坐标系无关(ego在哪无关了)。(高精地图可以用因为地图元素有长久的id,非高精地图应该就不好用了,地图元素的得在前后帧tracking住)
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
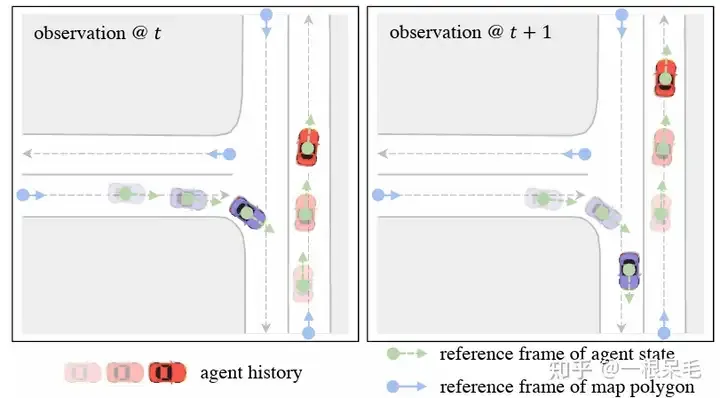
这使得我们可以把之前处理好的encoding结果进行重复使用,对于agent来说直接用这些cache的feature,这样就能节省latency了。
其次,为了更好地用这些场景encode结果进行多mode长时间预测,我们使用了anchor-free的query来一步步(在上一个位置的地方)提取场景的feature,这样每一次的decode都是非常短的一步。这个做法可以使得对于场景的特征提取重心放在agent未来在的某一个位置,而不是为了考虑未来多个时刻的位置,去提取远处的feature。这样得到的高质量anchor会在下一个refine的module进行精细调整。这样结合了anchor-free和anchor-based的做法充分利用了两个办法的优点,实现多mode长时间的预测。
这个做法是第一个探索了轨迹预测的连续性来实现高速inference的办法。同时decoder部分也兼顾了多mode和长时间预测的任务。
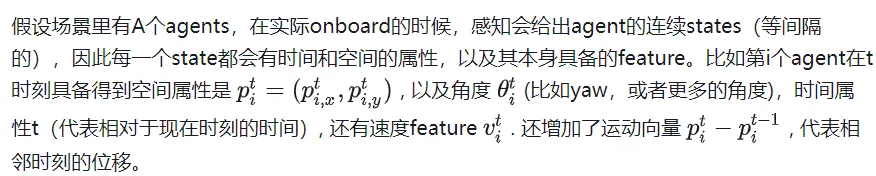
同时prediction模块还可以从高精地图获得M个polygon,每一个polygon都有多个点以及语义信息(crosswalk,lane等类型)。
预测模块使用T个时刻的上述的agent state和地图信息,要给出K个总共T'长度预测轨迹,同时还有其概率分布。
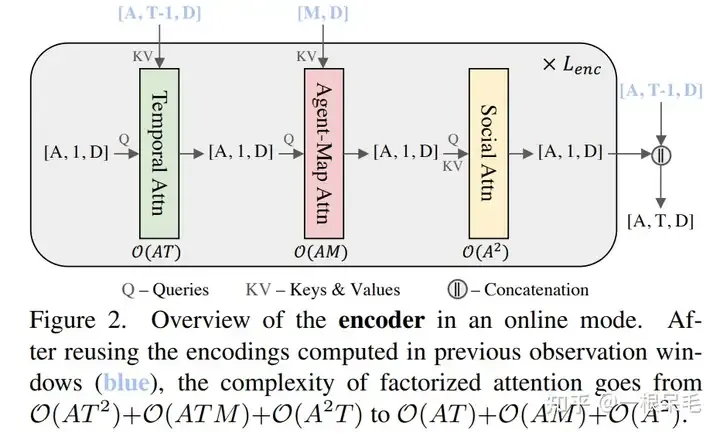
第一步自然是场景的encode。目前流行的factorized attention(时间和空间维度分别做attention)是这么做的,具体来说一共有三步:
这个做法和之前的先在时间维度压缩feature到当前时刻,再agent和agent,agent和地图间交互的做法比起来,是对于过去每个时刻去做交互,因此可以获取更多信息,比如agent和map间在每个时刻的交互演变。
但是缺点是三次方的复杂度随着场景变复杂,元素变多,会变得很大。我们的目标就是既用好这个factorized attention,同时不让时间复杂度这么容易爆炸。
一个很容易想到的办法是利用上一帧的结果,因为在时间维度上其实有T-1帧是完全重复的。但因为我们需要把这些feature旋转平移到agent当前帧的的位置和朝向,因此没法就这么使用上一帧运算得到的结果。
为了解决坐标系的问题,采用了query-centric办法,来学习场景元素的特征,而不依赖它们的全局坐标。这个做法对每个场景元素建立了局部的时空坐标系,在这个坐标系内提取特征,即使ego到别处,这个局部提取出来的特征也是不变的。这个局部时空坐标系自然也有一个原点位置和方向,这位置信息作为key,提取出来的特征作为value,便于之后的attention操作。整个做法分为下面几步:
对于agent i在t时刻的feature来说,选择这个时刻的位置和朝向作为参考系。对于map元素来说,则采用这个元素的起始点作为参考系。这样的参考系选择方法可以在ego移动后提取的feature保持不变。
对于每个元素内的别的向量特征,都在上述参考系里获取极坐标表示表达。然后将它们转成傅里叶特征来获取高频信号。concat上语义特征后再MLP获取特征。对于map元素,为了保证内部点的顺序不相关性,先做attention后pooling的操作。最后获得agent特征为[A, T, D], map特征为[M, D]. D是特征维度,保持一致才可以方便attention的矩阵相乘。这样提取出来的特征可以使得ego处于任何地方都能使用。
傅里叶embedding: 制造正态分布的embedding,对应各种频率的权重,乘输入和2Π, 最后取cos和sin作为feature。直观理解的话应该是把输入当作一个信号,把信号解码成多个基本信号(多个频率的信号)。这样可以更好的抓取高频信号,高频信号对于结果的精细程度很重要,一般的做法容易丢精细的高频信号。值得注意的是对于noisy数据不建议使用,因为会误抓错误的高频信号。(感觉有点像overfit,不能太general但又不能精准过头)
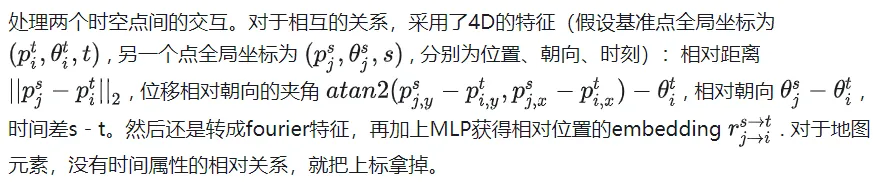
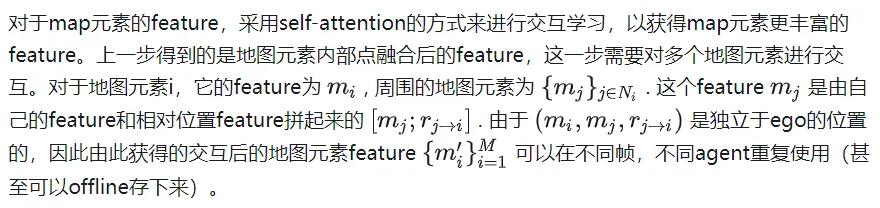
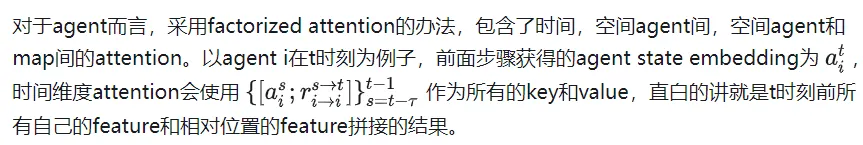


附近的定义为agent周围50m范围内。一共会进行次。
 Machine Translation
聚合多个来源的AI翻译
 49
查看详情

值得注意的是,通过以上方法得到的feature具备了时空不变性,即不管ego在什么时刻到什么地方,上述feature都是不变的,因为都没有针对当前的位置信息进行平移旋转。由于相比于上一帧只是多了新的一帧数据,并不需要计算之前的时刻的feature,所以总的计算复杂度除以了T。
类似于DETR的anchor-free query去某些key value里做attention的办法会导致训练不稳定,模态塌缩的问题,同时长时间预测也不靠谱,因为不确定度会在靠后时间爆炸。因此此模型采用了先来一次粗的anchor-free query办法,再对这个输出进行refine的anchor-base办法。
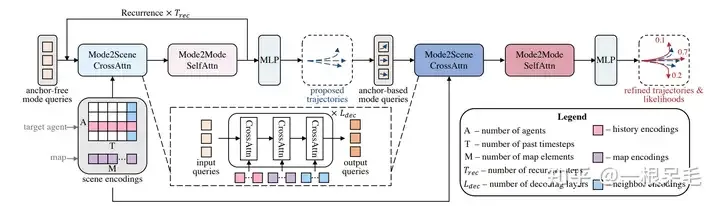 整个网络结构
Mode2Scene的两步都采用了DETR结构:query为K个轨迹mode(粗的proposal步是直接随机生成的,refine步是由proposal步得到的feature作为输入),然后在场景feature(agent历史,map,周围agent)上做多次cross attention。
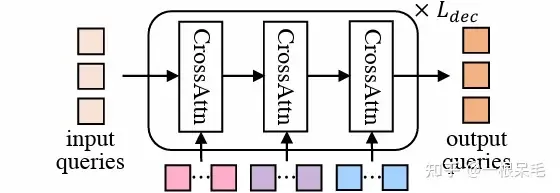 DETR结构
Mode2Mode则是在K个mode间进行self attention,企图实现mode间的diverse,不要都聚在一起。
为了并行预测多个agent的轨迹,场景的encoding是被多个agent分享的。因为场景feature都是相对于自身的feature,所以要使用的话还是得转到agent的视角下。对于mode的query,会附加上agent的位置和朝向信息。和之前encode相对位置类似的操作,也会对场景元素和agent的相对位置的信息进行embedding作为key和value。(直观上说就是agent每个mode在附近信息使用上的一个加权注意力)
第一次是anchor free的办法,采用可以学习的query来制造相对低质量的轨迹proposal,一共会产生K个proposal。由于会用cross attention的方式从场景信息里提取特征,因此可以高效产生比较少而有效的anchor供第二次refine使用。self attention则使得各proposal总体会更diverse。
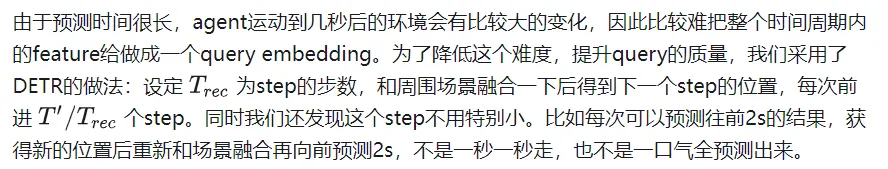
anchor free的办法虽然比较简单,但也存在训练不稳定的问题,有可能mode塌缩。同时,随机生成的mode还需要能在全场景里对于不同agent都有不错的表现,这比较难,很容易生成出不符合运动学的或者不符合交通的轨迹proposal。因此我们想到可以再来一次anchor-based修正。在proposal的基础上预测了一个offset(加到原proposal获得修正后轨迹),并预测了每个新轨迹的概率。
这个模块同样使用了DETR的形式,每个mode的query都是用上一步的proposal来提取,具体是用了一个小的GRU来embed每个anchor(一步步往前走),使用到最后一个时刻的feature作为query。这些基于anchor的query可以提供一定的空间信息,使得attention时更容易捕捉有用的信息。
和HiVT一样(参考HiVT的分析),采用Laplace分布。直白的讲就是把每个mode下每个时刻建模为一个laplace分布(参考一般的高斯分布,由mean和var,代表这个点的位置和其不确定性)。并且认为时刻之间是独立的(直接连乘)。Π代表了对应mode的概率。
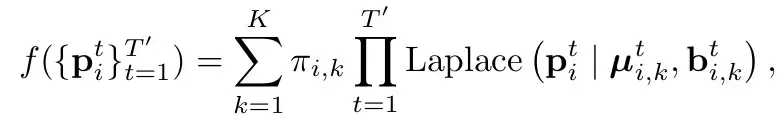
Loss的话由3部分组成
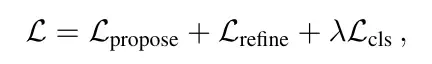
主要分为两部分:分类loss和回归loss。
分类loss是指预测概率的loss,这个地方要注意的是需要打断梯度回传,不可以让概率的引起的梯度传到对于坐标的预测(即在假设每个mode预测位置为合理的前提下)。label则是最接近gt的为1,别的都是0。
回归loss有两个,一个是一阶段的proposal的loss,一个是二阶段的refine的loss。采用赢者通吃的办法,即只计算最接近gt的mode的loss,两个阶段的回归loss都要算。为了训练的稳定性,此处在两个阶段中也打断了梯度回传,使得proposal学习就专门学习proposal,refine就只学refine。
Argoverse2基本各项SOTA(* 表示使用了ensemble技巧)
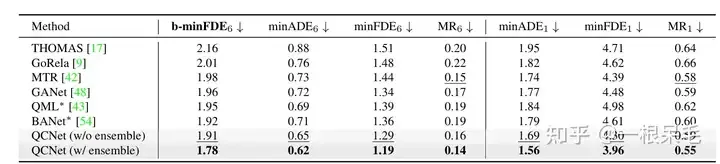
b-minFDE相比minFDE的区别在于额外乘上了和其概率相关的系数. 即目标希望FDE最小的那条轨迹的概率越高越好。
关于ensemble技巧,感觉是有点作弊的:可以参考BANet里的介绍,下面简单介绍一下。
生成轨迹的最后一步同时连做好多遍结构一样的submodel(decoder),会给出多组预测,比如有7个submodel,每个有6条预测,一共42条。然后用kmeans来进行聚类(以最后一个坐标点为聚类标准),目标是6组,每组7条,然后每组里面进行加权平均获得新轨迹。
加权方法如下,为当前轨迹和gt的b-minFDE,c为当前轨迹的概率,在每组里面进行权重计算,然后对轨迹坐标加权求和获得一条新轨迹。(感觉多少有些tricky,因为c其实是这个轨迹在submodel输出里的概率,拿来在聚类里算有点不太符合预期)
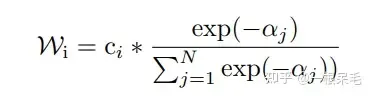
并且这么操作后新轨迹的概率也很难精准计算,不能用上述方法,否则总概率和就不一定是1了。似乎也只能等权重地算聚类里的概率了。
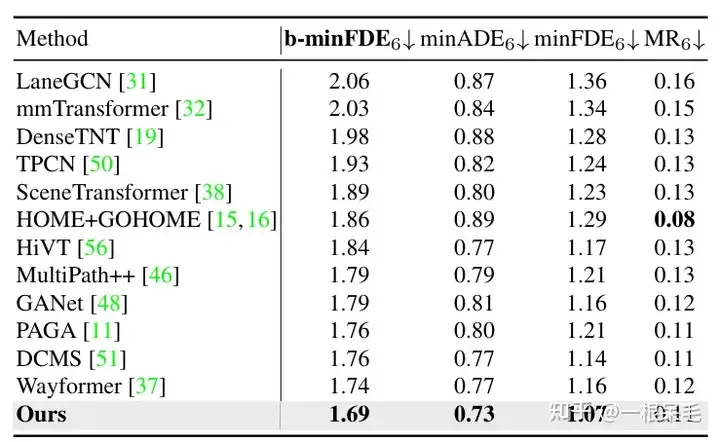
Argoverse1也是遥遥领先
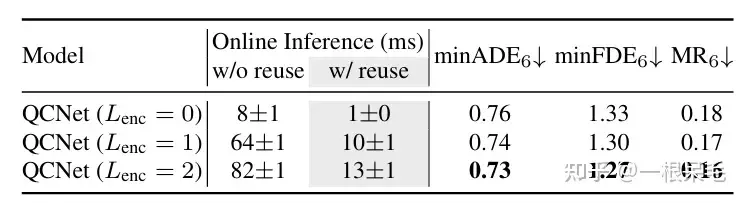
关于场景encode的研究:如果复用了之前的场景encode结果,infer的时间可以大幅减少。agent和场景信息的factorized attention交互次数变多,预测效果也会变好,只是latency也涨的很凶,需要权衡。
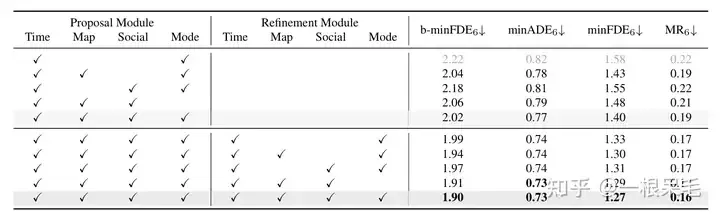
各种操作的研究:证明了refine的重要性,以及factorized attention在各种交互中的重要性,缺一不可。
以上就是轨迹预测系列 | HiVT之进化版QCNet到底讲了啥?的详细内容,更多请关注其它相关文章!
# 自己的
# 清远网站优化价格表报价
# 蓝天作文网站建设工作
# 合肥seo优化公司
# 园岭外贸独立网站推广
# 沧州产品营销推广公司
# 专业网站建设机构
# 仙桃网站推广优化开发
# 江苏seo优化口碑推荐
# 常德快手营销推广方式
# sem营销推广方式外推
# 不稳定
# 预测
# 采用了
# 上一
# 的是
# 长时间
# 都是
# 多个
# 进化版
# 讲了
# access
# 轨迹
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
借力AI!PCB全球巨头,有爆发潜质吗?
【趋势周报】全球人工智能产业发展趋势:OpenAI向美国专利局提交“GPT-5”商标申请
微软Xbox称VR和AR还需要时间 先玩大的
苹果AI战略与微软谷歌大相径庭,到底是领先还是落后?
科技数码圈的新物种 乐天派桌面机器人 AI +安卓+机器人 首发价1799元
第 66 届格莱美奖规定,AI 作品将无法获得评奖资格
数据显示:人工智能相关专业热度上升最快 考古、美术、生物医学工程等小众专业火了
【搞事】时隔4年 谷歌更新安卓logo 机器人头更饱满了
云米Smart 2E AI立式空调开启预售:新三级能效,到手价3899元
Databricks推出人工智能模型共享机制,可令开发者与公司“双赢”
大模型的“黄金搭档”来了!腾讯云正式发布AI原生向量数据库,提供10亿级向量检索能力
人工智能赋能无人驾驶:商业化进程再提速
人才智能平台转型中的人工智能的关键角色
清华系面壁智能开源中文多模态大模型VisCPM :支持对话文图双向生成,吟诗作画能力惊艳
OpenAI 静默关闭 AI 文本检测工具,准确率仅为 26%
小米又拿下国际比赛第一:AI翻译立功
Meta 开源 AI 语言模型 MusicGen,可将文本和旋律转化为完整乐曲
创新科学家成功研发FAST激光靶标维护机器人
国产医疗企业的人工智能
2025世界人工智能大会前沿科技共绘“未来”图景, 这家这家独角兽企业的通用大脑将在AI领域大放异彩
物联网“僵尸网络DDos攻击”增长惊人,威胁全球电信网络
最大助力35公斤 外骨骼机器人或在养老、医疗领域“大展身手”
出门问问亮相2025世界人工智能大会,展示AI CoPilot解决方案
实测 AI 建筑设计软件的自动生成效果图能力
午报 | 字节跳动要造机器人;东方甄选首次启动自有APP|直播|
中国电信AI能力通过国家级金融领域权威认证并荣膺AI国际头部竞赛冠军
OpenAI宣布组建新团队 以控制“超级智能”人工智能
当科幻走进现实 脑机接口新技术能为生活带来哪些惊喜?
AI教父Bengio:我感到迷失,对AI担忧已成「精神内耗」!
OpenAI首席执行官表态支持欧盟AI监管
【澎湃原动力】人工智能产业协同创新中心:全产业链资源在这里汇聚
网易加速行业AI大模型应用,将覆盖100多个应用场景
掌阅科技对话式AI应用“阅爱聊”开启内测
如何对员工进行再培训以充分利用供应链管理中的人工智能创新
旷视入选北京市通用人工智能产业创新伙伴计划
12页线性代数笔记登GitHub热榜,还获得了Gilbert Strang大神亲笔题词
水路两栖艇、消防灭火机器人……这个展览“黑科技”抢眼
国内AI大模型“安卓时刻”到来!阿里云通义千问免费、开源、可商用
农业产业升级:AI驱动的“崃·见田”开启农田未来展望
马斯克预测:特斯拉全自动驾驶将在今年实现 对AI深度变化感到担忧
Dubbo负载均衡策略之 一致性哈希
无需照相馆,AI证件照生成软件即将推出
人工智能行业急缺人 AI人才年薪能达近42万元
重塑未来生活的五项技术趋势
用AI升级会议体验!思必驰多款会议产品亮相全球智博会!
陈根:ChatGPT和人类合作开发机器人
280万条多模态指令-响应对,八种语言通用,首个涵盖视频内容的指令数据集MIMIC-IT来了
先进技术在防止全球数据丢失方面的作用
人工智能产业协同创新中心:全产业链资源在这里汇聚
重磅! 捷通华声灵云AICC荣获第二届光合组织AI解决方案大赛二等奖
2024-04-12

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
