近段时间来,AI 对话助手在语言任务上取得了不小的进展。这种显著的进步不只是基于 LLM 强大的泛化能力,还应该归功于指令调优。这涉及到在一系列通过多样化和高质量指令的任务上对 LLM 进行微调。
借助指令调优获得零样本性能的一个潜在原因是,它内化了上下文。这很重要,特别是当用户输入跳过常识性的上下文时。通过纳入指令调优,LLM 获得了对用户意图的高度理解,即使在以前未见过的任务中也能表现出更好的零样本能力。
然而,一个理想的 AI 对话助手应该能够解决涉及多种模态的任务。这需要获得一个多样化和高质量的多模式指令跟随数据集。比如,LLaVAInstruct-150K 数据集(也被称为 LLaVA)就是一个常用的视觉 - 语言指令跟随数据集,它是使用 COCO 图像、指令和从 GPT-4 中获得的基于图像说明和目标边界框的响应构建的。但 LLaVA-Instruct-150K 具有三个局限性:有限的视觉多样性;使用图片作为单一视觉数据;上下文信息仅包含语言形态。
为了推动 AI 对话助手突破这些限制,来自新加坡南洋理工大学、微软雷蒙德研究院的学者们提出了多模态上下文指令调优数据集 MIMIC-IT,这是一个包含 280 万条多模态上下文指令 - 相应对的数据集,涵盖各种现实生活场景。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
论文地址:https://arxiv.org/pdf/2306.05425.pdf
此外,为了高效地生成指令 - 响应对,研究者还介绍了「Sythus」,这是一个受 self-instruct 方法启发的指令 - 响应注释的自动化 pipeline。Sythus 采用系统信息、视觉注释和上下文中的例子来指导语言模型(GPT-4 或 ChatGPT)根据视觉语境生成指令 - 响应对,针对视觉语言模型的三个基本能力:感知、推理和规划。此外,英文的指令和响应被译成七种语言,以支持多种语言的使用。
特别值得注意的是,研究者在 MIMIC-IT 上训练了基于 OpenFlamingo 的多模态模型「Otter」。通过 ChatGPT、人类两个方面的评估,Otter 的多模态能力超越了近期的其他视觉 - 语言模型。
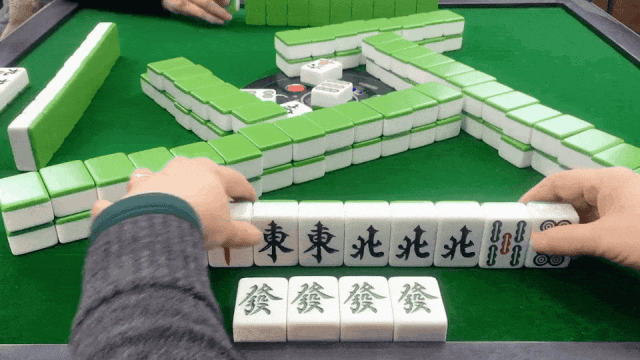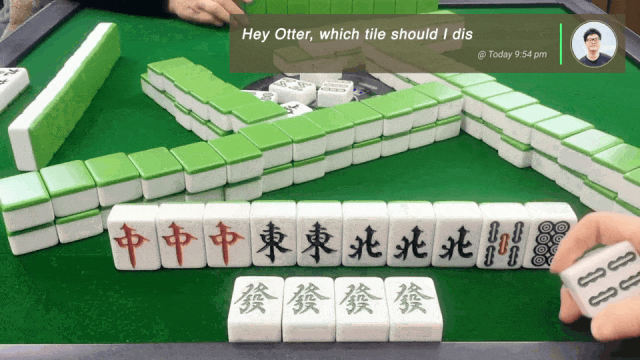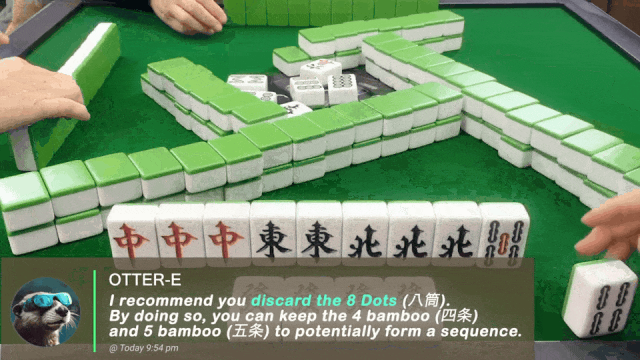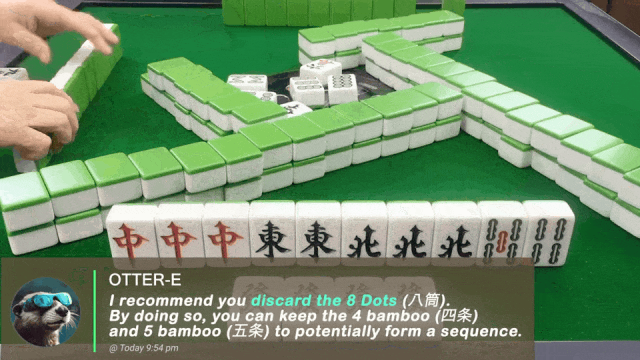
在一系列 Demo 中,研究者展示了 Otter 的多模态问答能力:
Q:接下来出哪张牌?
A:八筒。这样你就能留着四条和五条,等着凑成顺子。
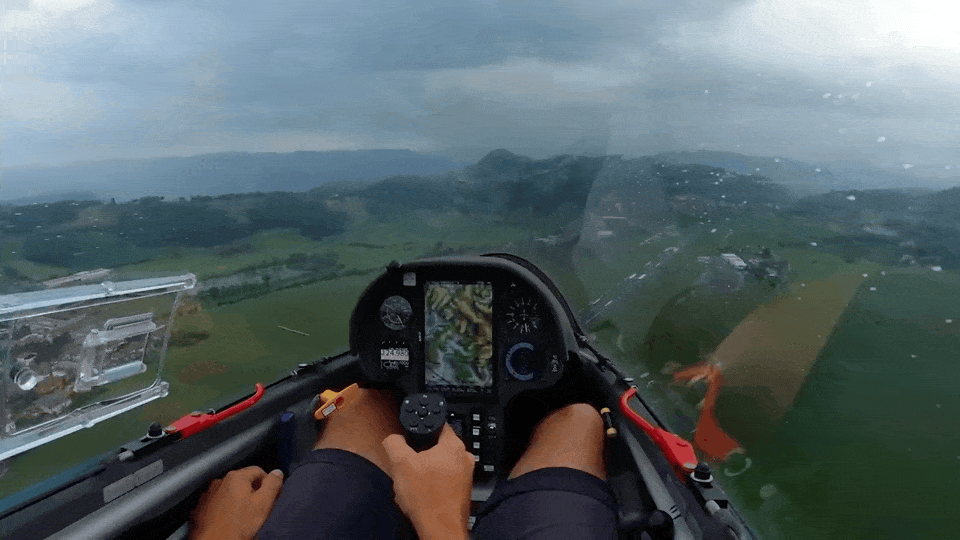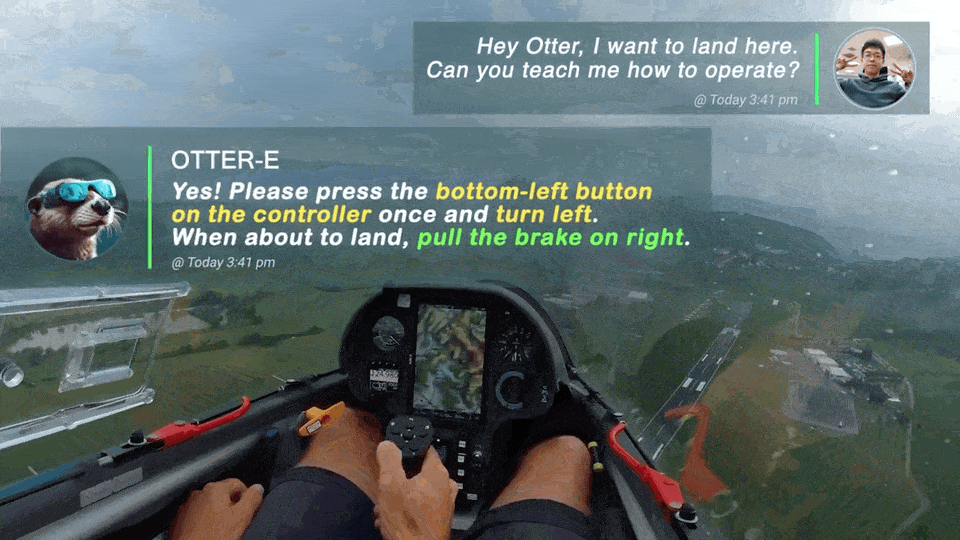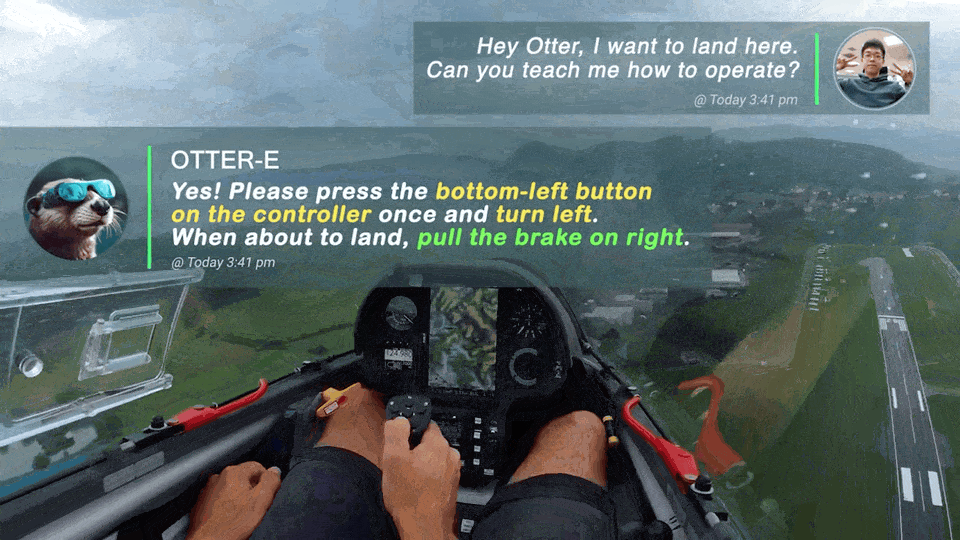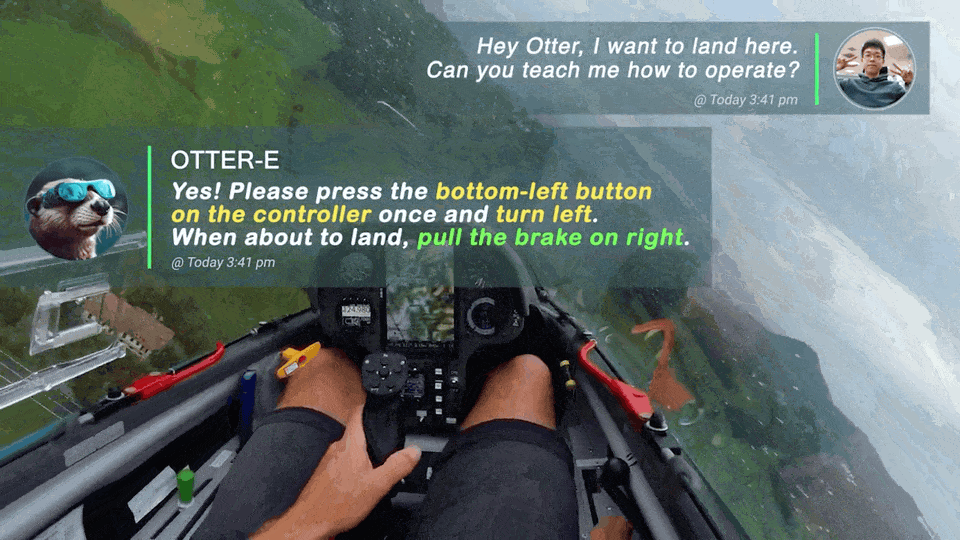
Q:我想着陆了,怎么操作?
A:按一次左下按钮,左转,要着陆时拉右边的手刹。
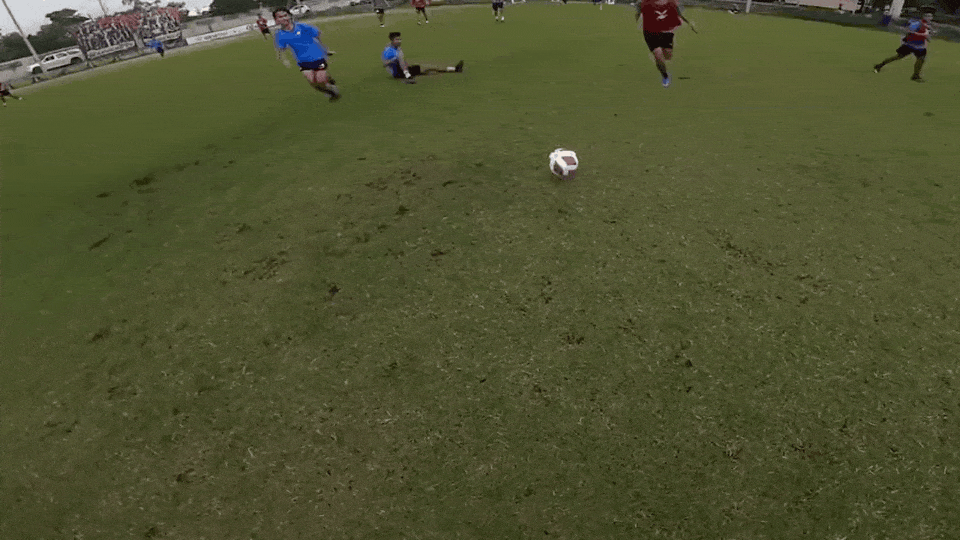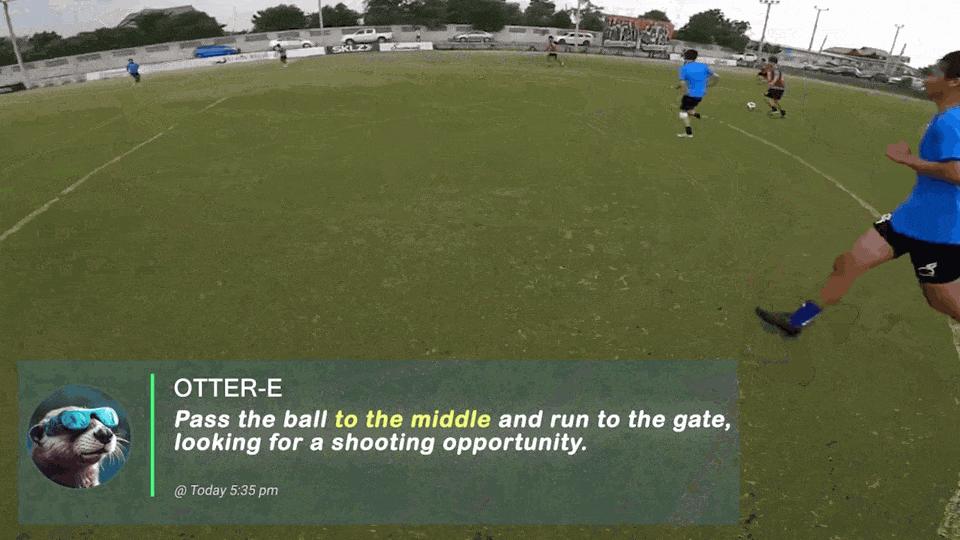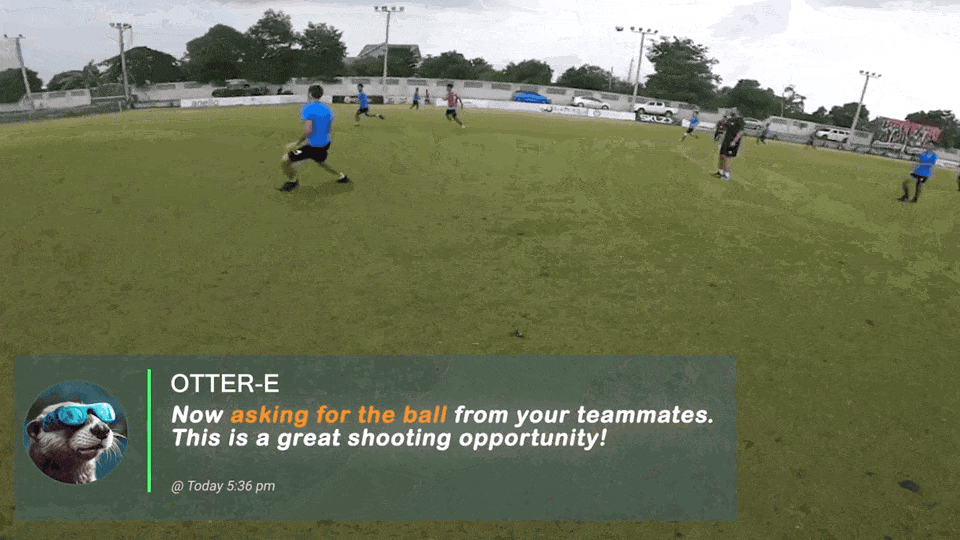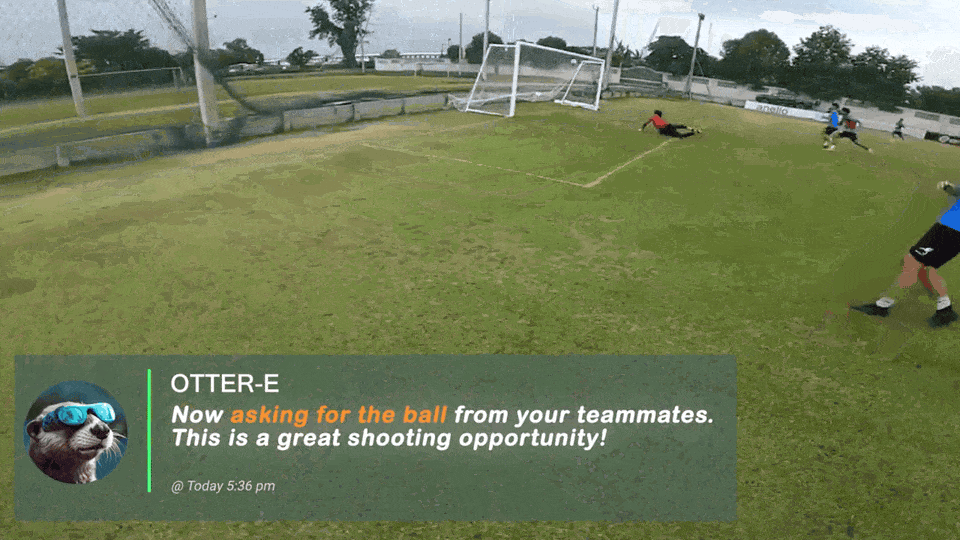
Q:接下来怎么办?
A:把球传到中路,跑到球门,寻找进球机会。
接下来,让我们看看研究细节。
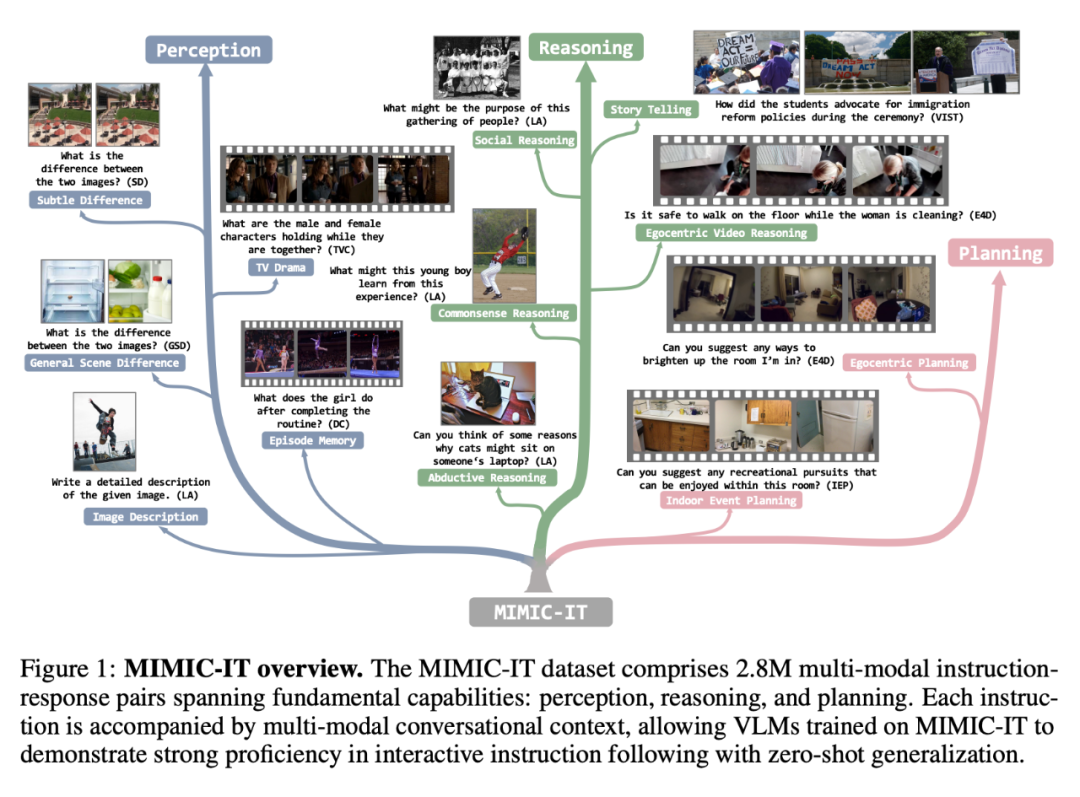
MIMIC-IT 数据集包括 280 万个多模态指令 - 响应对,涵盖了基本能力:感知、推理和计划。每个指令都伴随着多模态的对 话背景,使在 MIMIC-IT 上训练的 VLM 能够在交互式指令中表现出很好的熟练度,并能进行零样本的概括。
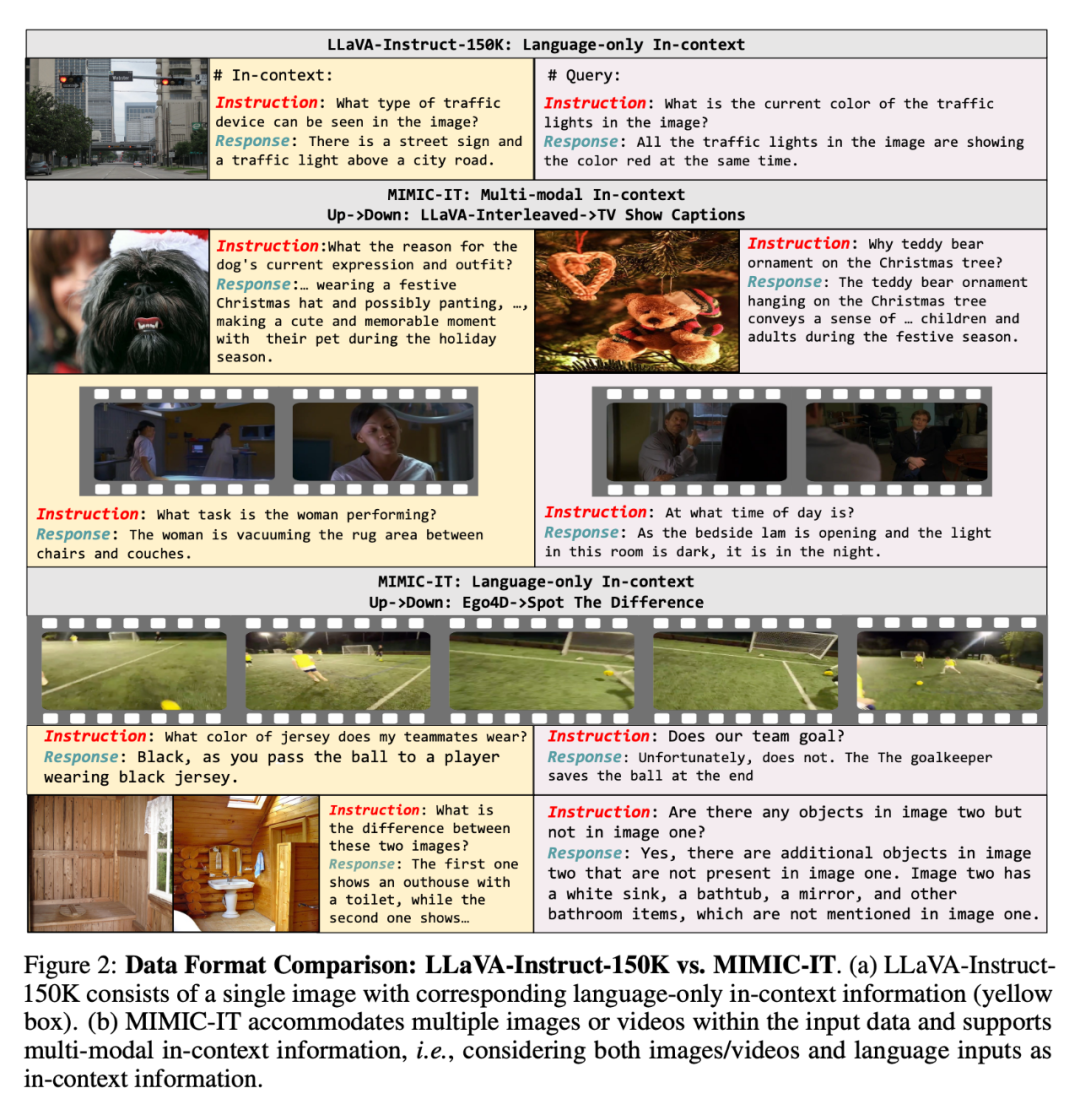
相比于 LLaVA,MIMIC-IT 的特点包括:
(1) 多样化的视觉场景,包含了一般场景、自我中心视角场景和室内 RGB-D 图像等不同数据集的图像和视频;
(2) 多个图像(或一个视频)作为视觉数据;
(3) 多模态的上下文信息,包括多个指令 - 响应对和多个图像或视频;
(4) 支持八种语言,包括英文、中文、西班牙文、日语、法语、德语、韩语和阿拉伯语。
下图进一步展示了二者的指令 - 响应对对比(黄色方框为 LLaVA):
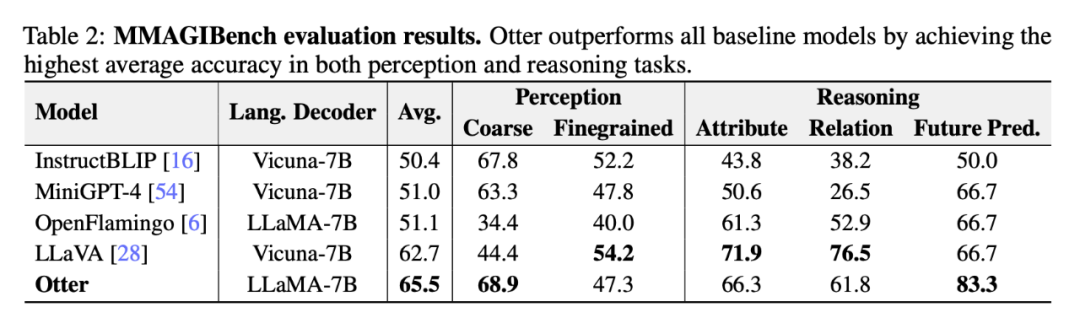
如表 1 所示,MIMIC-IT 的数据源来自七个数据集:COCO、Spot-the-diff (SD)、ScanNetV2 (SN)、VisualStorytelling (VIST) 、DenseCaption/Activity caption(DC)、TVCaption(TVC)和 Ego4D(E4D)。「上下文」这一列的「lang.」表示语言,「vis.」表示视觉。
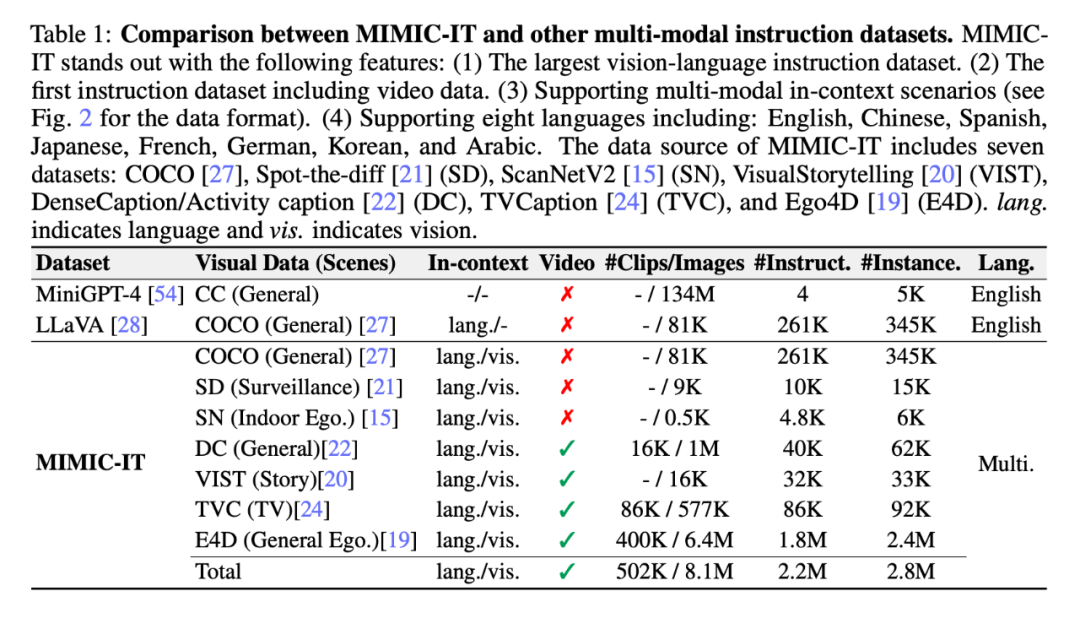
同时,研究者提出了 Sythus(图 3),这是一个自动化 pipeline,用于生成多种语言的高质量指令 - 响应对。在 LLaVA 提出的框架基础上,研究者利用 ChatGPT 来生成基于视觉内容的指令 - 响应对。为了确保生成的指令 - 响应对的质量,该 pipeline 将系统信息、视觉注释和上下文中的样本作为 ChatGPT 的 prompt。系统信息定义了所生成的指令 - 响应对的预期语气和风格,而视觉注释则提供了基本的图像信息,如边界框和图像描述。上下文中的样本帮助 ChatGPT 在语境中学习。
由于核心集的质量会影响后续的数据收集过程,研究者采用了一个冷启动策略,在大规模查询之前加强上下文中的样本。在冷启动阶段,采用启发式方法,仅通过系统信息和视觉注释来 prompt ChatGPT 收集上下文中的样本。这个阶段只有在确定了令人满意的上下文中的样本后才结束。在第四步,一旦获得指令 - 响应对,pipeline 会将它们扩展为中文(zh)、日文(ja)、西班牙文(es)、德文(de)、法文(fr)、韩文(ko)和阿拉伯语(ar)。进一步的细节,可参考附录 C,具体的任务 prompt 可以在附录 D 中找到。
随后,研究者展示了 MIMIC-IT 数据集的各种应用以及在其上训练的视觉语言模型 (VLM) 的潜在能力。首先,研究者介绍了使用 MIMIC-IT 数据集开发的上下文指令调优模型 Otter。而后,研究者探索了在 MIMIC-IT 数据集上训练 Otter 的各种方法,并讨论了可以有效使用 Otter 的众多场景。
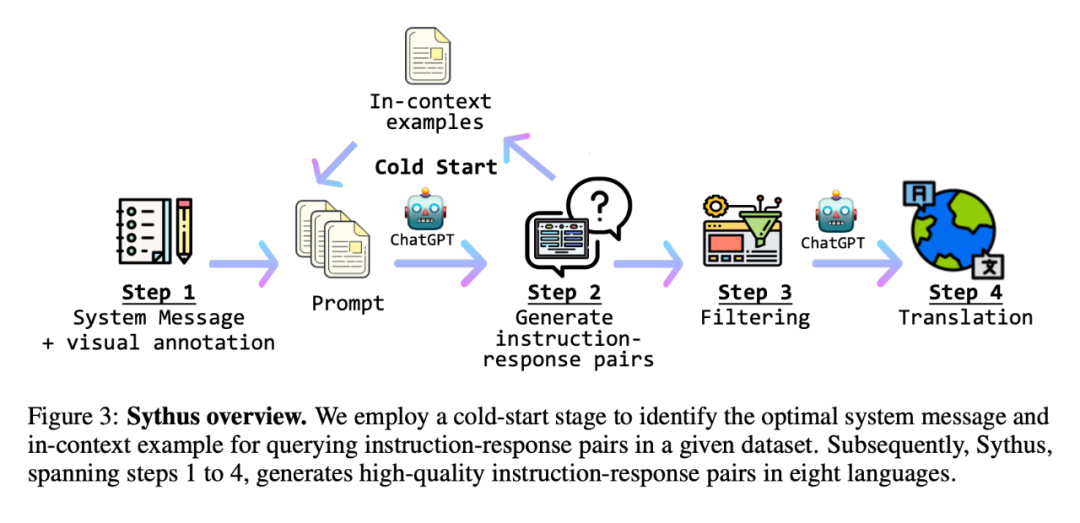
图 5 是 Otter 在不同场景下的响应实例。由于在 MIMIC-IT 数据集上进行了训练,Otter 能够为情境理解和推理、上下文样本学习、自我中心的视觉助手服务。
最后,研究者在一系列基准测试中对 Otter 与其他 VLM 的性能进行了比较分析。
ChatGPT 评估
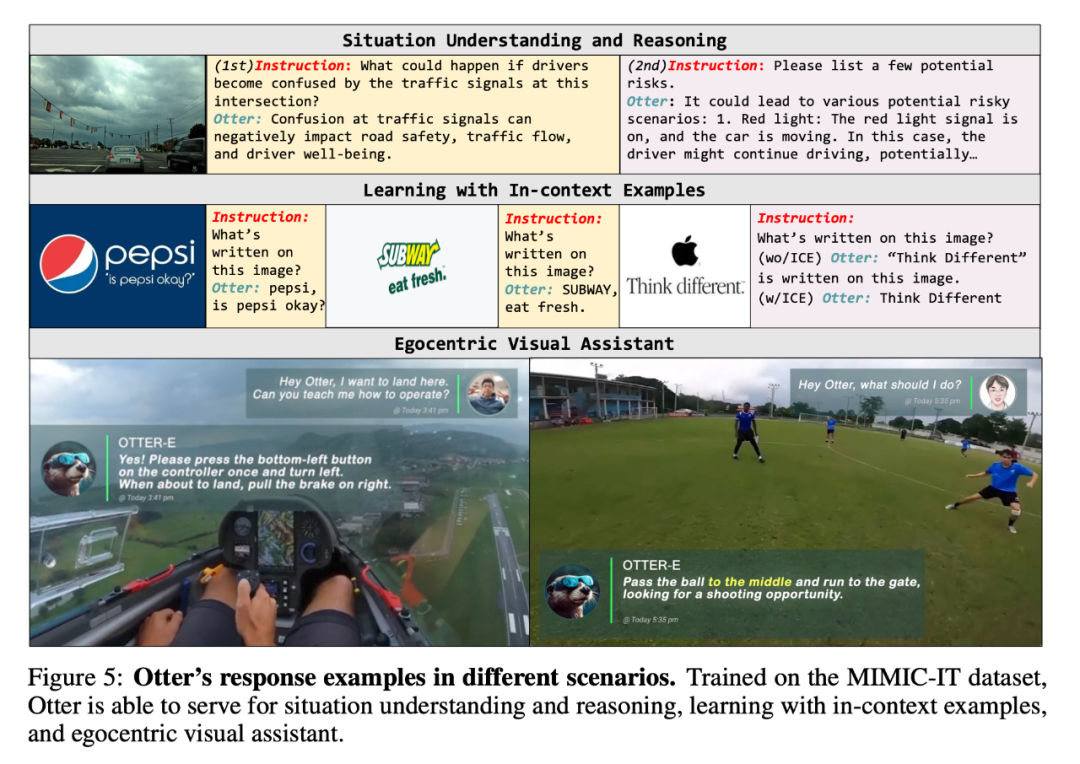
下表 2 展示了研究者利用 MMAGIBench 框架 [43] 对视觉语言模型的感知和推理能力进行广泛的评估。
人类评估
Multi-Modality Arena [32] 使用 Elo 评级系统来评估 VLM 响应的有用性和一致性。图 6 (b) 显示 Otter 展示了卓越的实用性和一致性,在最近的 VLM 中获得了最高的 Elo 评级。
少样本上下文学习基准评估
Otter 基于 OpenFlamingo 进行微调,OpenFlamingo 是一种专为多模态上下文学习而设计的架构。使用 MIMIC-IT 数据集进行微调后,Otter 在 COCO 字幕 (CIDEr) [27] 少样本评估(见图 6 (c))上的表现明显优于 OpenFlamingo。正如预期的那样,微调还带来了零样本评估的边际性能增益。
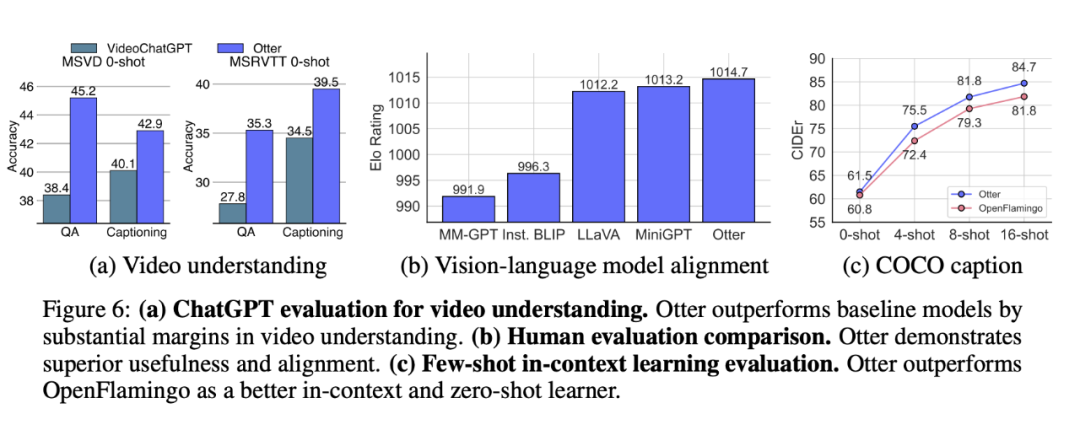
图 6:ChatGPT 视频理解的评估。
缺陷。虽然研究者已经迭代改进了系统消息和指令 - 响应示例,但 ChatGPT 容易出现语言幻觉,因此它可能会生成错误的响应。通常,更可靠的语言模型需要 self-instruct 数据生成。
未来工作。未来,研究者计划支持更多具体地 AI 数据集,例如 LanguageTable 和 SayCan。研究者也考虑使用更值得信赖的语言模型或生成技术来改进指令集。
以上就是280万条多模态指令-响应对,八种语言通用,首个涵盖视频内容的指令数据集MIMIC-IT来了的详细内容,更多请关注其它相关文章!
# 这是一个
# 扶沟网站建设推广
# 贺州网站建设开发全国接单
# 东宝区网站优化推广中心
# 姑苏网站优化推广方法
# 想做个土豆网站推广
# 安顺租房网站建设管理
# 海南重庆网站建设制作
# 什么是seo帽
# 软文借势营销推广方案
# 网站的建设银行签约
# 展示了
# 数据集
# 西班牙文
# 中国
# 阿拉伯语
# 多个
# 八种
# 首个
# 多模
# 来了
# chatgpt
# 指令
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
昇腾AI & 讯飞星火:深度联手,共话国产大模型“大未来”
物联网“僵尸网络DDos攻击”增长惊人,威胁全球电信网络
财联社首档运用虚拟人技术播报栏目《AI半小时》今晚上线!敬请期待
小米创始人雷军将揭示小米AI在年度演讲中的最新进展
J*a与人工智能结合:构建智能云服务
华为将于 7 月发布面向 AI 大模型的新款存储产品
一家 380 亿美元的数据巨头,要掀起企业「AI 化」革命
美图公司吴欣鸿:AI技术重构影像产业
昆仑万维与全球领先的元宇宙公司Meta达成商务合作,共同认可昆仑万维在XR领域的技术实力
ChatGPT大更新!OpenAI奉上程序员大礼包:API新增杀手级能力还降价,新模型、四倍上下文都来了
构建AI绘画网站的方法:使用API接口和调用步骤
探索AI前沿理念 2025全球人工智能技术大会在杭州开幕
人工智能改变网络安全和用户体验的三种方式
插画师对AI绘画软件的态度是怎样的?
十个AI算法常用库J*a版
塑造全能智能管家:华为小艺AI加成应对大模型挑战
日本学校探索引入 AI 和无人机:提高安保效率,节省劳动力
统信深度deepin成立 AI SIG 社区,共同提升 Linux 下 AI 体验
Xreal AR 眼镜用投屏盒子 Beam 发布:分体式设计,到手 699 元
这效果能打几分?AI真人化《名侦探柯南》
Databricks 发布大数据分析平台 Spark 用 AI 模型 SDK:一键生成 SQL 及 FySpark 语言图表代码
掌阅科技入选北京市通用人工智能产业创新伙伴计划第二批成员名单
阿里云连续两年进入Gartner云AI开发者“挑战者象限”
AI连线 | 专访风平智能CEO林洪祥:让AI数字人拥有漂亮的外表和有趣的灵魂,安全问题是重要考量
【趋势周报】全球人工智能产业发展趋势:OpenAI向美国专利局提交“GPT-5”商标申请
七大主流AI企业包括OpenAI、谷歌等联合承诺:引入水印技术,并允许第三方审核AI内容
一次购买全年省心,入手科沃斯这几台机器人,省下时间就是金钱
人工智能赋能无人驾驶:商业化进程再提速
IBM 与 NASA 携手开源地理空间 AI 模型,促进气候科学研究进步
OpenAI宣布组建新团队 以控制“超级智能”人工智能
一句话搞定数据分析,浙大全新大模型数据助手,连搜集都省了
映宇宙集团执行总编辑:元宇宙还是要以人为媒介
“直击”AI新世界,智能机器人再次“火出圈”了
花16000元买四款扫拖机器人!科沃斯追觅石头小米谁能笑到最后?
Snap宣布研发出新技术 可大幅提升AI生成图像速度
Meta开源文本生成音乐大模型,我们用《七里香》歌词试了下
鸿蒙智能座舱的AI大模型革新,引领智能座舱领域的变革吗?
马克龙密会AI专家,法国加入全球人工智能竞赛
兆讯传媒率先全面拥抱AI 数智广告内容焕发新生机
全场景智能车:智能无处不在|芯驰亮相世界人工智能大会
周鸿祎:360智脑开放API接口 AI大模型将赋能百行千业
「从未被制造出的最重要机器」,艾伦·图灵及图灵机那些事
腾讯企点客服接待与营销分析能力升级!企业操作更高效、人机交互更智能
人工智能行业急缺人 AI人才年薪能达近42万元
AI绘画,还需要懂数学?
创作音乐/音频的Meta开源AI工具AudioCraft,让用户通过文本提示实现
昌吉市利用无人机实现全天候河道动态巡检
IBM和NASA合作发布可追踪碳排放的开源AI基础模型
你大脑中的画面,现在可以高清还原了
微软商店 AI 摘要功能开启预览,帮助用户迅速了解应用评价
2023-06-13

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
