近几年,图像生成领域取得了巨大的进步,尤其是文本到图像生成方面取得了重大突破:只要我们用文本描述自己的想法,AI 就能生成新奇又逼真的图像。
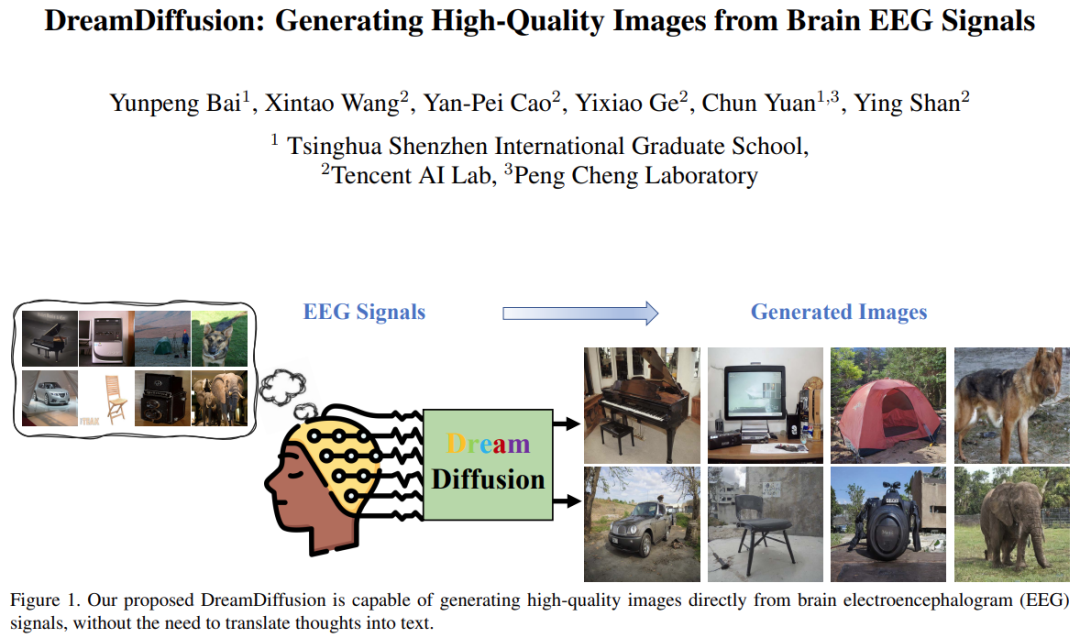
但其实我们可以更进一步 —— 将头脑中的想法转化为文本这一步可以省去,直接通过脑活动(如 EEG(脑电图)记录)来控制图像的生成创作。
这种「思维到图像」的生成方式有着广阔的应用前景。例如,它能极大提高艺术创作的效率,并帮助人们捕捉稍纵即逝的灵感;它也有可能将人们夜晚的梦境进行可视化;它甚至可能用于心理治疗,帮助自闭症儿童和语言障碍患者。
最近,来自清华大学深圳国际研究生院、腾讯 AI Lab 和鹏城实验室的研究者们联合发表了一篇「思维到图像」的研究论文,利用预训练的文本到图像模型(比如 Stable Diffusion)强大的生成能力,直接从脑电图信号生成了高质量的图像。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
 图片
论文地址:https://arxiv.org/pdf/2306.16934.pdf
项目地址:https://github.com/bbaaii/DreamDiffusion
 Android 应用框架原理与程序设计36技pdf繁体版
Android应用框架原理与程序设计36技 pdf繁体版,书籍内容适用于Android 1.0,有些朋友可能对Android还不太熟悉吧?不知您是否听说过Google 在HTC定制的高端手机呢?其操作系统是基于Android的,如果还是不太清楚的话,可以Google一下“HTC g2”手机,可以大致了解一下手机操作系统的界面及架构特点。不管怎么说,Android手机编程目前还是主要面向高端,在将来可能会普及,因此Android编程还是很有必要掌握的。
 0
查看详情

近期一些相关研究(例如 MinD-Vis)尝试基于 fMRI(功能性磁共振成像信号)来重建视觉信息。他们已经证明了利用脑活动重建高质量结果的可行性。然而,这些方法与理想中使用脑信号进行快捷、高效的创作还差得太远,这主要有两点原因:
首先,fMRI 设备不便携,并且需要专业人员操作,因此捕捉 fMRI 信号很困难;
其次,fMRI 数据采集的成本较高,这在实际的艺术创作中会很大程度地阻碍该方法的使用。
相比之下,EEG 是一种无创、低成本的脑电活动记录方法,并且现在市面上已经有获得 EEG 信号的便携商用产品。
但实现「思维到图像」的生成还面临两个主要挑战:
1)EEG 信号通过非侵入式的方法来捕捉,因此它本质上是有噪声的。此外,EEG 数据有限,个体差异不容忽视。那么,如何从如此多的约束条件下的脑电信号中获得有效且稳健的语义表征呢?
2)由于使用了 CLIP 并在大量文本 - 图像对上进行训练,Stable Diffusion 中的文本和图像空间对齐良好。然而,EEG 信号具有其自身的特点,其空间与文本和图像大不相同。如何在有限且带有噪声的 EEG - 图像对上对齐 EEG、文本和图像空间?
为了解决第一个挑战,该研究提出,使用大量的 EEG 数据来训练 EEG 表征,而不是仅用罕见的 EEG 图像对。该研究采用掩码信号建模的方法,根据上下文线索预测缺失的 token。
不同于将输入视为二维图像并屏蔽空间信息的 MAE 和 MinD-Vis,该研究考虑了 EEG 信号的时间特性,并深入挖掘人类大脑时序变化背后的语义。该研究随机屏蔽了一部分 token,然后在时间域内重建这些被屏蔽的 token。通过这种方式,预训练的编码器能够对不同个体和不同脑活动的 EEG 数据进行深入理解。
对于第二个挑战,先前的解决方法通常直接对 Stable Diffusion 模型进行微调,使用少量噪声数据对进行训练。然而,仅通过最终的图像重构损失对 SD 进行端到端微调,很难学习到脑信号(例如 EEG 和 fMRI)与文本空间之间的准确对齐。因此,研究团队提出采用额外的 CLIP 监督,帮助实现 EEG、文本和图像空间的对齐。
具体而言,SD 本身使用 CLIP 的文本编码器来生成文本嵌入,这与之前阶段的掩码预训练 EEG 嵌入非常不同。利用 CLIP 的图像编码器提取丰富的图像嵌入,这些嵌入与 CLIP 的文本嵌入很好地对齐。然后,这些 CLIP 图像嵌入被用于进一步优化 EEG 嵌入表征。因此,经过改进的 EEG 特征嵌入可以与 CLIP 的图像和文本嵌入很好地对齐,并更适合于 SD 图像生成,从而提高生成图像的质量。
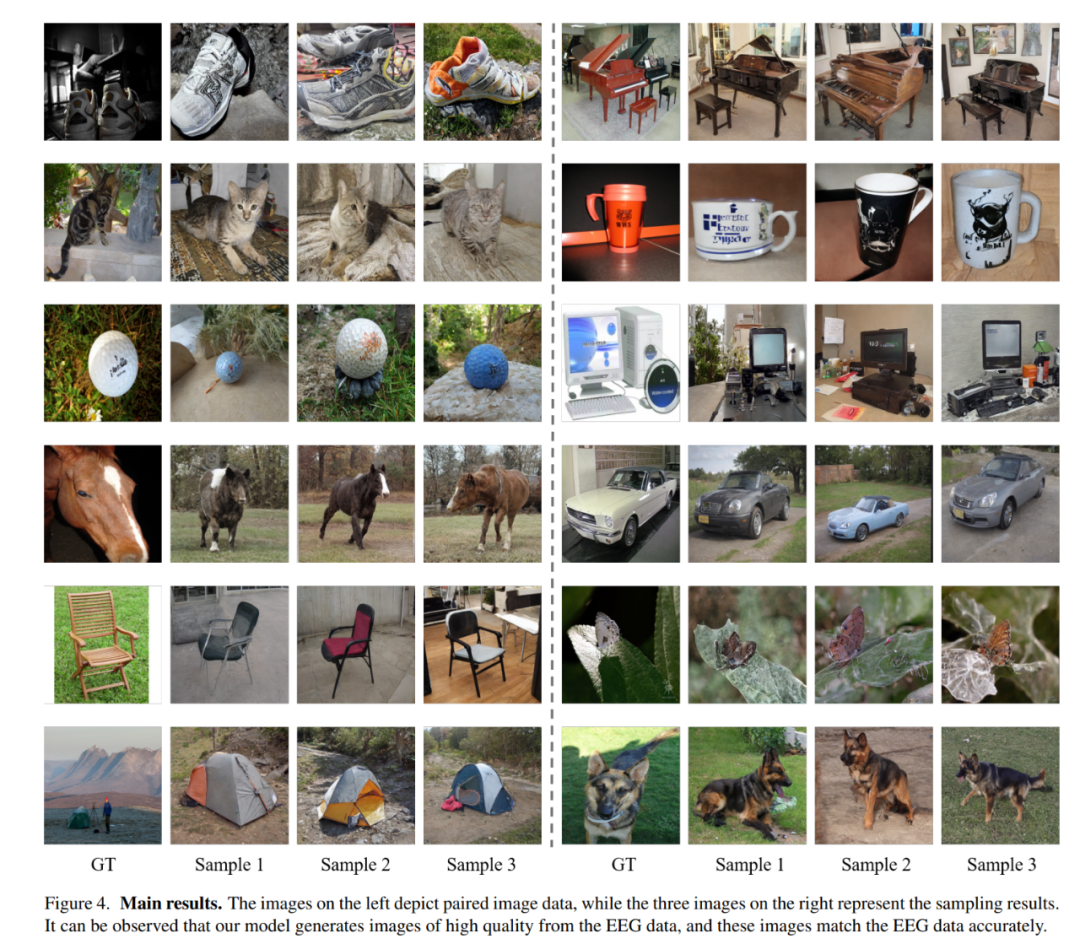
基于以上两个精心设计的方案,该研究提出了新方法 DreamDiffusion。DreamDiffusion 能够从脑电图(EEG)信号中生成高质量且逼真的图像。
 图片
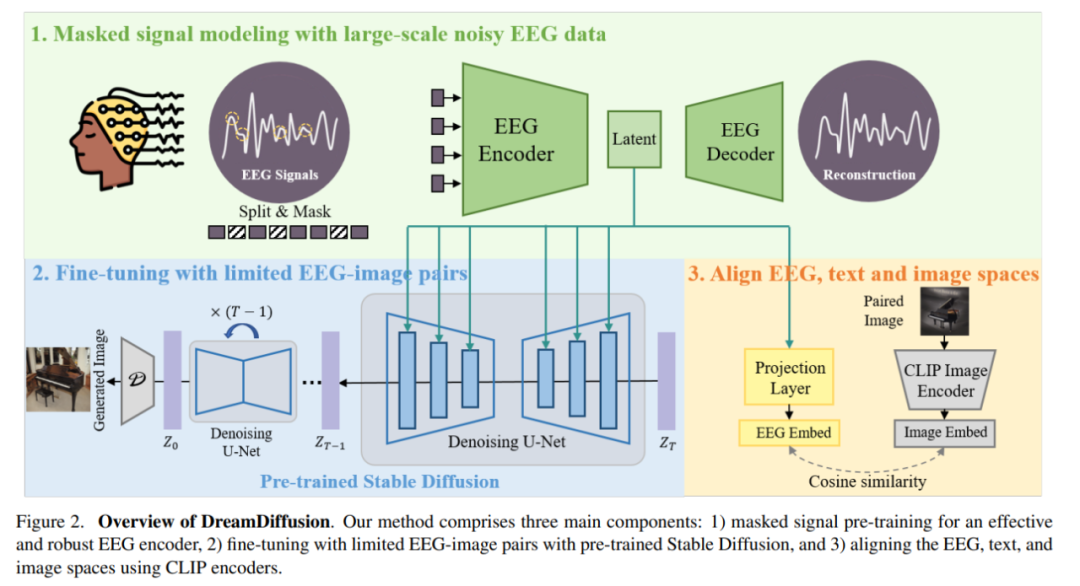
具体来说,DreamDiffusion 主要由三个部分组成:
1)掩码信号预训练,以实现有效和稳健的 EEG 编码器;
2)使用预训练的 Stable Diffusion 和有限的 EEG 图像对进行微调;
3)使用 CLIP 编码器,对齐 EEG、文本和图像空间。
首先,研究人员利用带有大量噪声的 EEG 数据,采用掩码信号建模,训练 EEG 编码器,提取上下文知识。然后,得到的 EEG 编码器通过交叉注意力机制被用来为 Stable Diffusion 提供条件特征。
 图片
为了增强 EEG 特征与 Stable Diffusion 的兼容性,研究人员进一步通过在微调过程中减少 EEG 嵌入与 CLIP 图像嵌入之间的距离,进一步对齐了 EEG、文本和图像的嵌入空间。
与 Brain2Image 对比
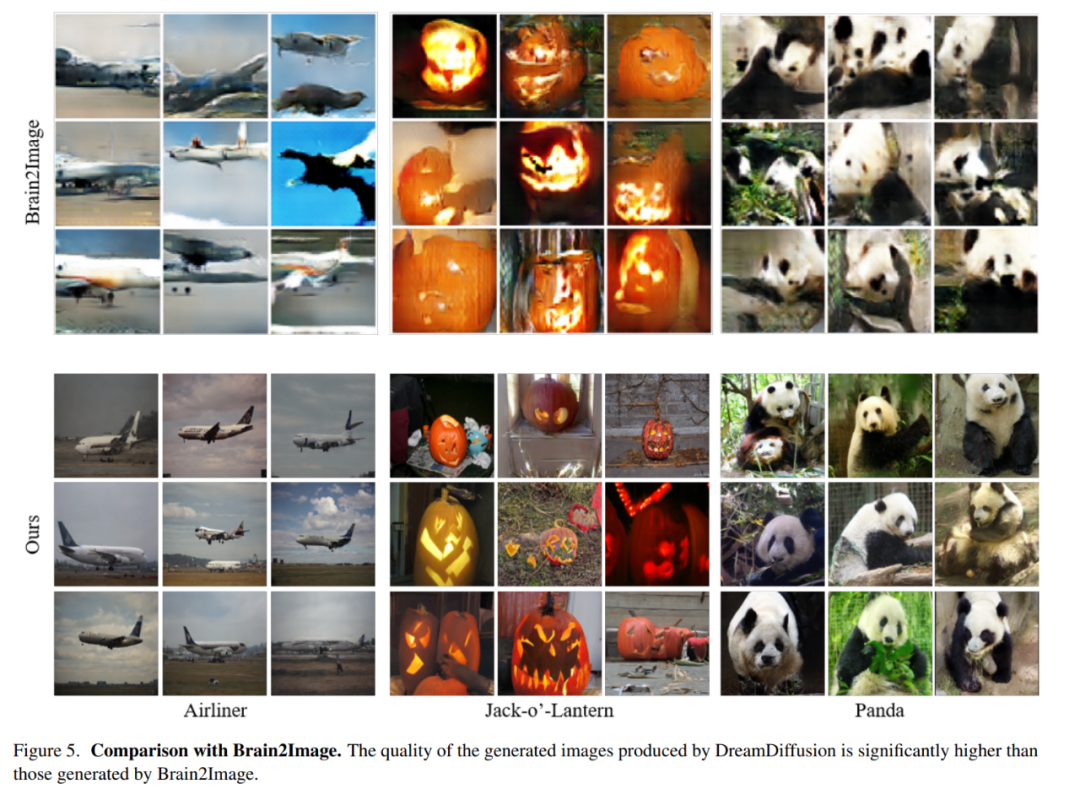
研究人员将本文方法与 Brain2Image 进行比较。Brain2Image 采用传统的生成模型,即变分自编码器(VAE)和生成对抗网络(GAN),用于实现从 EEG 到图像的转换。然而,Brain2Image 仅提供了少数类别的结果,并没有提供参考实现。
鉴于此,该研究对 Brain2Image 论文中展示的几个类别(即飞机、南瓜灯和熊猫)进行了定性比较。为确保比较公平,研究人员采用了与 Brain2Image 论文中所述相同的评估策略,并在下图 5 中展示了不同方法生成的结果。
下图第一行展示了 Brain2Image 生成的结果,最后一行是研究人员提出的方法 DreamDiffusion 生成的。可以看到 DreamDiffusion 生成的图像质量明显高于 Brain2Image 生成的图像,这也验证了本文方法的有效性。
 图片
消融实验
预训练的作用:为了证明大规模 EEG 数据预训练的有效性,该研究使用未经训练的编码器来训练多个模型进行验证。其中一个模型与完整模型相同,而另一个模型只有两层的 EEG 编码层,以避免数据过拟合。在训练过程中,这两个模型分别进行了有 / 无 CLIP 监督的训练,结果如表 1 中 Model 列的 1 到 4 所示。可以看到,没有经过预训练的模型准确性有所降低。
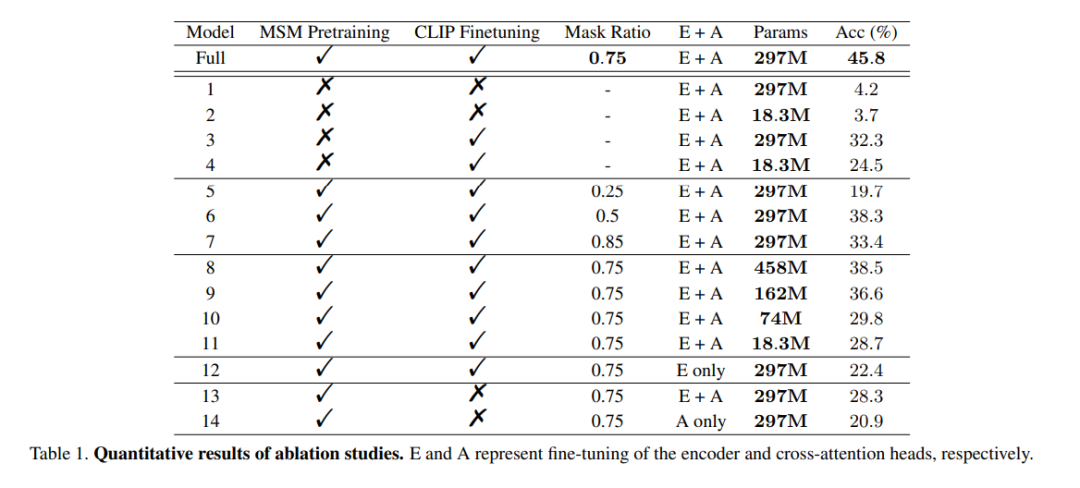
mask ratio:本文还研究了用 EEG 数据确定 MSM 预训练的最佳掩码比。如表 1 中的 Model 列的 5 到 7 所示,过高或过低的掩码比会对模型性能都会产生不利影响。当掩码比为 0.75 达到最高的整体准确率。这一发现至关重要,因为这表明,与通常使用低掩码比的自然语言处理不同,在对 EEG 进行 MSM 时,高掩码比是一个较好的选择。
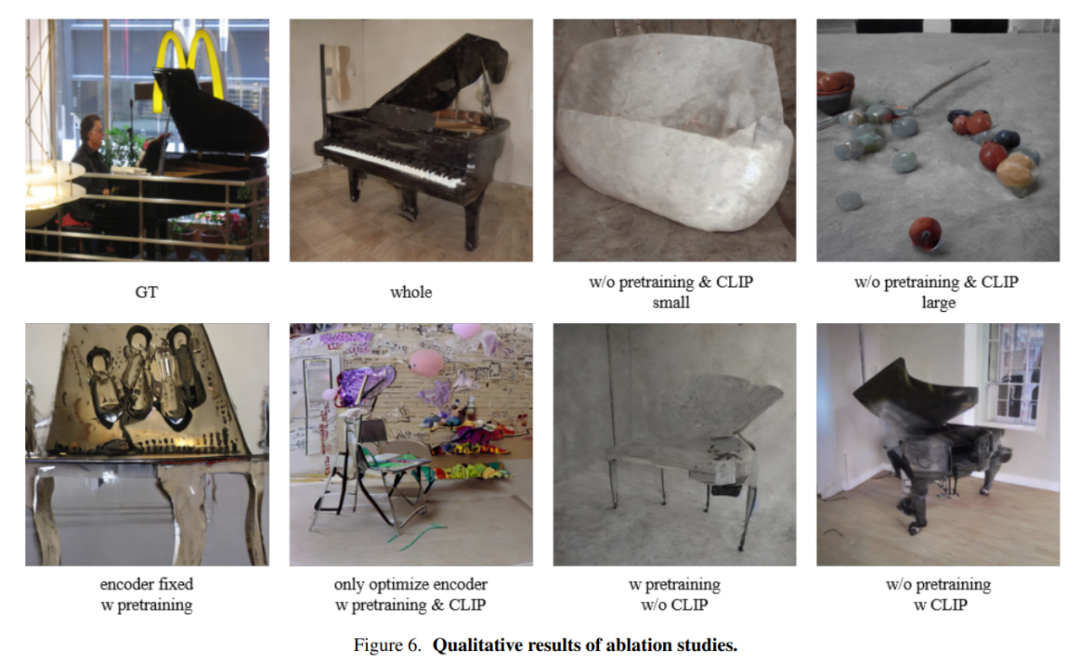
CLIP 对齐:该方法的关键之一是通过 CLIP 编码器将 EEG 表征与图像对齐。该研究进行实验验证了这种方法的有效性,结果如表 1 所示。可以观察到,当没有使用 CLIP 监督时,模型的性能明显下降。实际上,如图 6 右下角所示,即使在没有预训练的情况下,使用 CLIP 对齐 EEG 特征仍然可以得到合理的结果,这凸显了 CLIP 监督在该方法中的重要性。
 图片
以上就是你大脑中的画面,现在可以高清还原了的详细内容,更多请关注其它相关文章!
# ai
# 浙江电商网站推广多少钱
# seo里填写什么意思
# 刘学超seo
# 淘宝外部网站的推广特点
# 乌苏营销推广运营思路
# 大气网站建设哪家好
# 并在
# 重构
# 不太
# 很好
# 万元
# 高质量
# 所示
# 程序设计
# 掩码
# 脑中
# stable diffusion
# 创意
# 网站建设优化推广采购
# 昆山建设网站的
# 360网站优化论坛
# 新媒体营销推广的特点
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
谷歌推出 AI 反洗钱工具,可将金融机构内部风险预警准确率提高2至4倍
意大利警察拟用AI预测犯罪 该算法被指种族歧视严重
AI人工智能软件,婚纱设计师的必备利器
AI会帮我们把活干完吗?
网友自制 AI 版《流浪地球 3》预告片,登上 CCTV6
马克龙密会AI专家,法国加入全球人工智能竞赛
AI生成会议纪要 百度如流升级推出超级助手、智能编码等功能
纪录片 《寻找人工智能》全集1080P超清
AI工具助力公司实施每周4.5天工作制,带来巨大效益
生活垃圾智能分类机器人社区展“才能”,征求居民意见
即将到来:AI婚纱设计软件实际测试,人工智能即将开创婚纱设计新纪元
如何用AI开创智慧能源新时代?固德威正让能源“通人性”!
放弃自动驾驶,也是一种和解
马斯克发推讽刺人工智能,机器学习本质是统计?
AI浪潮席卷,时空壶为何能成为AI翻译时代的破局者
ChatGPT会成为你家新的语音助手吗?
报告称 70% 程序员已使用各种 AI 工具编程
构建AI绘画网站的方法:使用API接口和调用步骤
AI生成新闻网站数量激增,正在疯狂赚取广告收入
OpenOOD更新v1.5:全面、精确的分布外检测代码库及测试平台,支持在线排行榜、一键测试
研究发现AI聊天机器人ChatGPT不会讲笑话,只会重复25个老梗
“可用”“有用”的讯飞星火认知大模型将亮相世界人工智能大会
商汤科技:元萝卜 AI 下棋机器人新品发布会 6 月 14 日举行
编程版GPT狂飙30星,AutoGPT危险了!
智能手机应用中的人工智能的重要性
郭帆:AI发展日新月异,或是弯道超车好莱坞的最好机会
掌阅科技对话式AI应用“阅爱聊”开启内测
腾讯自主研发机器狗 Max 升级,可“奔跑跳跃”完成避障动作
联想创投携手12家被投企业MWC展示元宇宙、机器人等技术
AI时代,企业需要什么样的员工?
MIT开发“PhotoGuard”技术保护图像免遭恶意AI编辑
开创全新虚拟现实体验的Pimax Crystal VR头显
Midjourney 5.2震撼发布!原画生成3D场景,无限缩放无垠宇宙
构建数字文旅新高地!洛阳涧西区开启元宇宙时代
生成式人工智能来了,如何保护未成年人? | 社会科学报
Meta 为打造元宇宙不惜下血本:VR 开发者年薪高达百万美元
Gartner发布中国企业人工智能趋势浪潮3.0
成功孵化首个大型模型解决方案的重庆人工智能创新中心
游族AI创新院揭牌成立 推进AI赋能游戏业务
人工智能驱动艺术,打开达利的超现实想象
人工智能如何改变未来语言?
上天下海登极,青岛与昇腾AI握手一起探索星辰大海
AI大模型紫东太初已被注册商标 中科院已注册紫东太初大模型商标
云鲸发布全新的扫拖机器人J4系列
前特斯拉总监、OpenAI大牛Karpathy:我被自动驾驶分了心,AI智能体才是未来!
加强高质量数据供应能力,促进通用人工智能大模型领域的创新
再也不怕「视频会议」尬住了!谷歌CHI顶会发布新神器Visual Captions:让图片做你的字幕助手
报道称亚马逊正在测试AI生成产品评价摘要
360发布认知型通用大模型“360智脑4.0” 全面接入360全家桶
传Meta 2025年推出首款AR眼镜,采用军用级别材料,计划生产1000台
2023-07-06

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
