☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
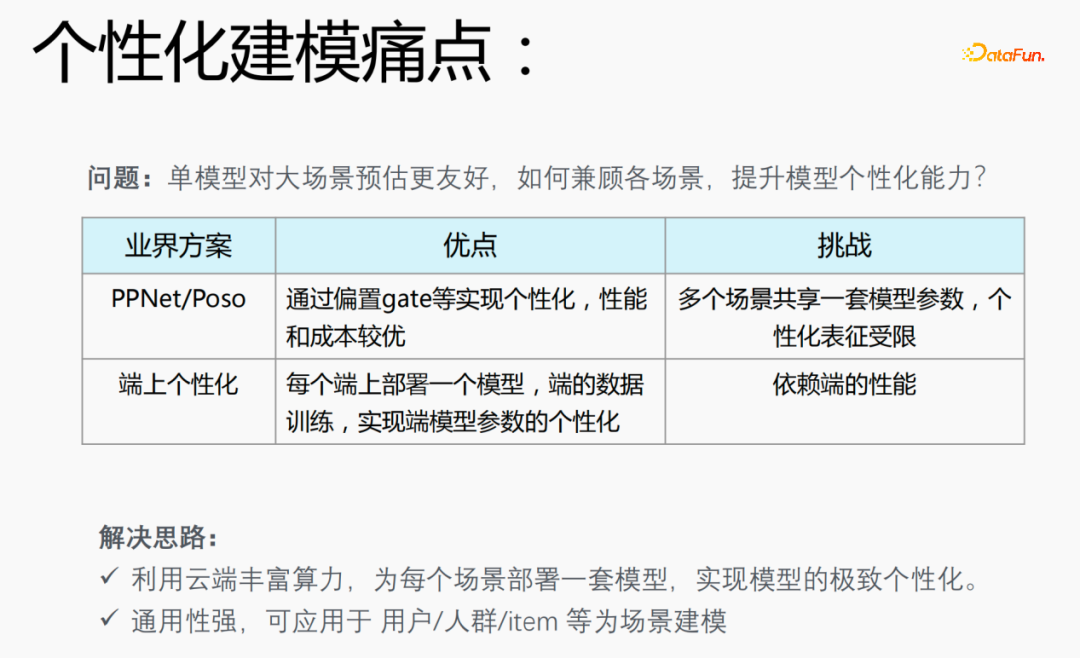
在推荐场景会遇到数据二八分布的问题,20%的场景应用80%的样本,这就导致一个问题:单模型对大场景预估更友好。如何兼顾各场景,提升模型个性化能力是个性化建模的痛点。
业界方案:
针对业界模型存在的问题,我们提出了如下解决思路:
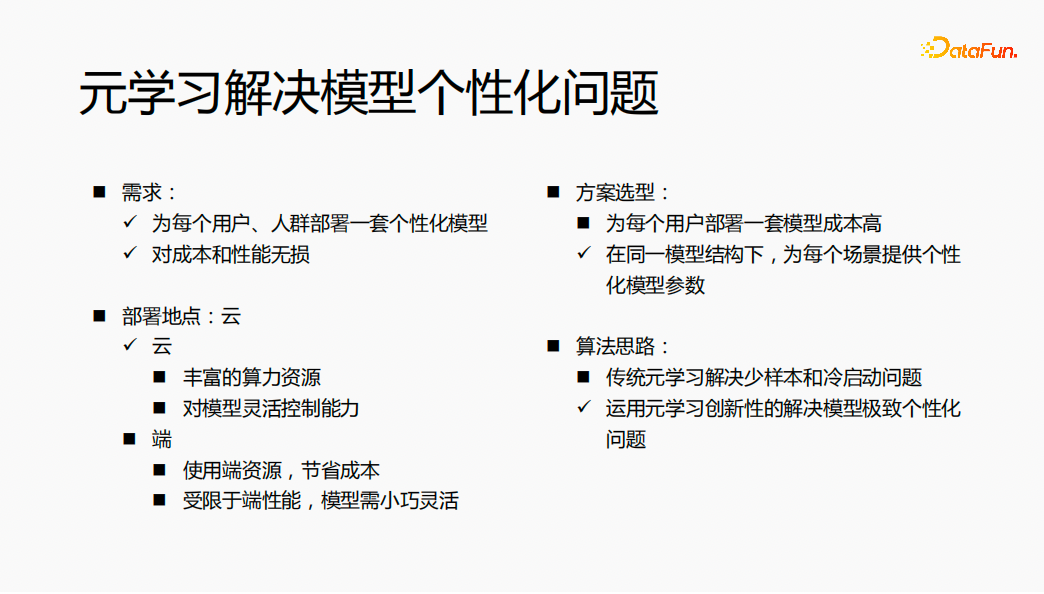
整体思路是利用元学习在云端为每一个用户部署一套个性化模型参数,最终达到对成本和性能没有损失的效果。
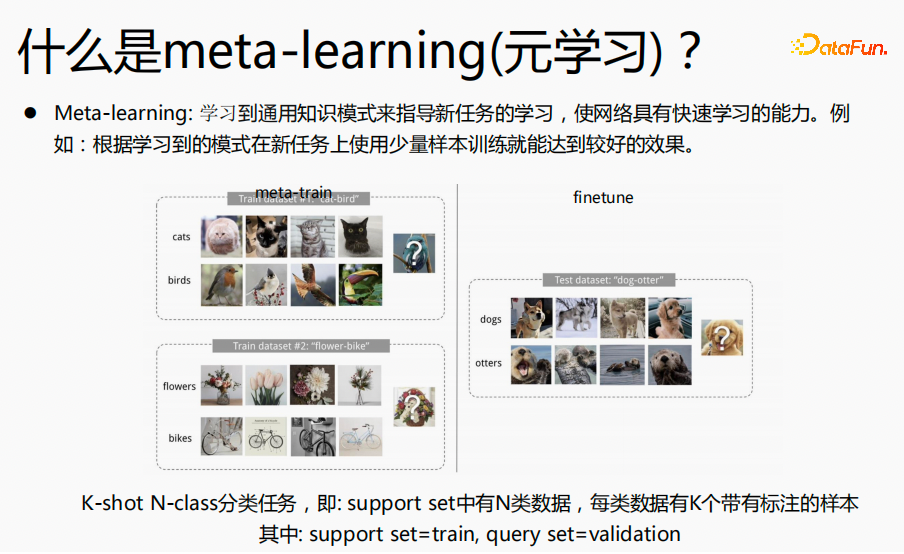
元学习指的是学习到通用知识来指导新任务的算法,使得网络具有快速的学习能力。例如:上图中的分类任务:猫和鸟、花朵和自行车,我们将这种分类任务定义成K-short N-class 的分类任务,希望通过元学习,学习到分类知识。在预估finetune过程,我们希望对于狗和水獭这样的分类任务,用很少的样本,进行微调就能得到极致的预估效果。再举一例,我们在学习四则混合运算时,先学习加减,后学习乘除,当这两个知识掌握了,我们就能够学习这两个知识融在一起如何来算,对于加减乘除混合运算,我们并不是分开来算,而是在加减乘除的基础上,学习先乘除后加减的运算规则,再用一些样本来训练这个规则,以便快速了解这个规则,以至于在新的预估数据上得到比较好的效果。元学习的思路与此类似。
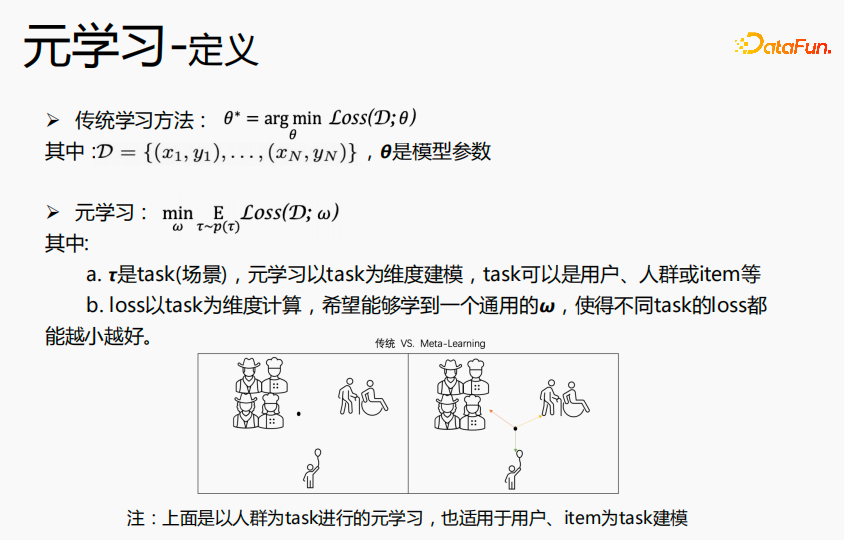
传统的学习方法,目标是学习到使得所有数据达到最优的θ,即全局最优的θ。元学习是以task为维度,来学习场景上的通用 ,在所有场景上面loss都能达到最优。传统的学习方法学到的θ,更靠近大场景的人群,对大场景预估更好,对中长尾预估效果一般;元学习是学习到各个场景都相近的一个点,在用每个场景的数据或新的场景的数据在这个点上进行微调,达到各个场景最优的一个点。所以可以实现,在每一个场景构建个性化的模型参数,达到极致个性化的目标。上述实例中是以人群为task进行元学习,也适用于用户或item为task进行建模。
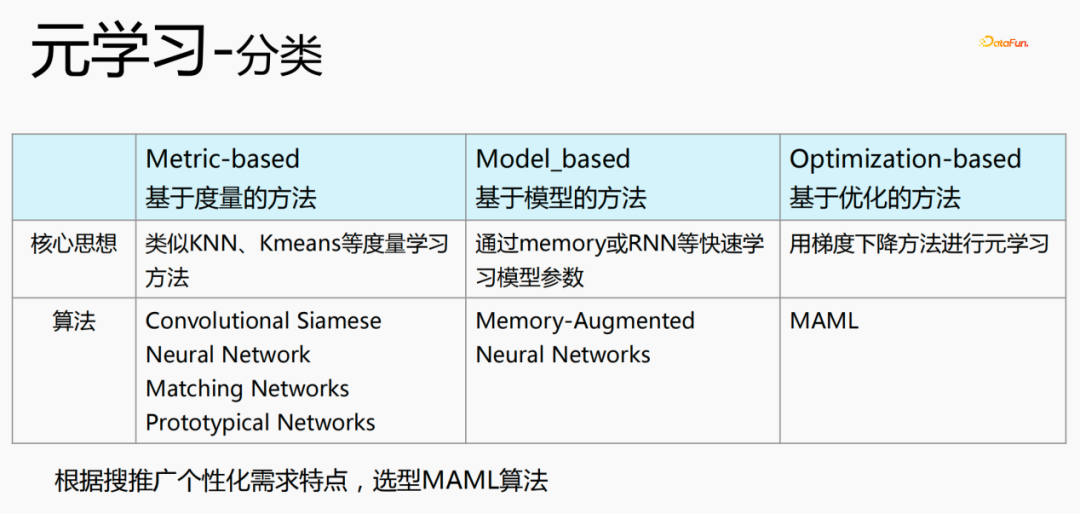
元学习有三种分类:
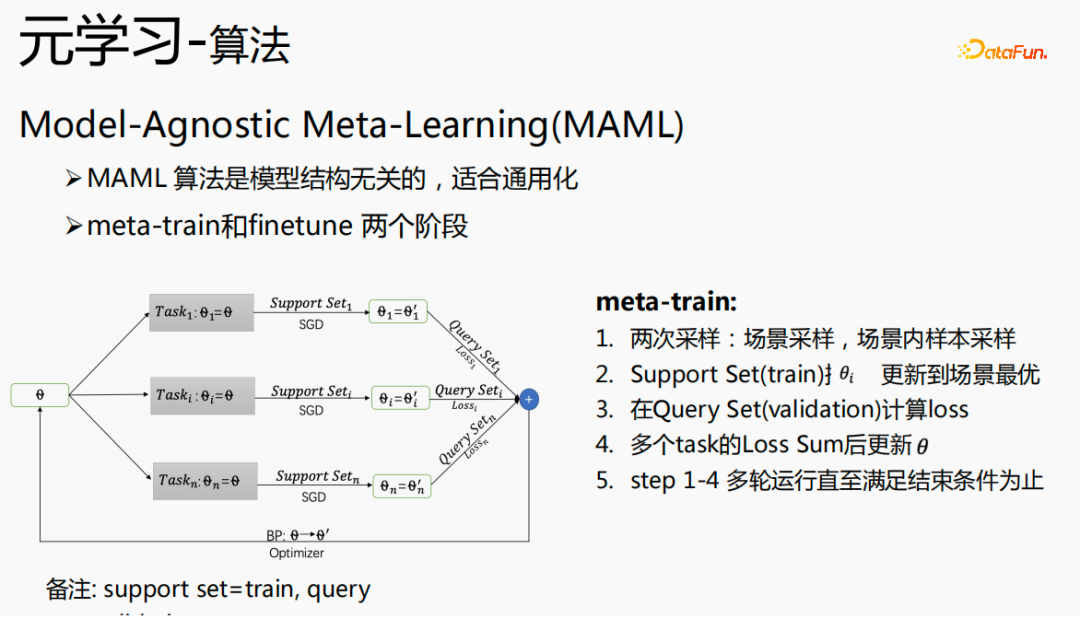
Model-Agnostic Meta-Learning(MAML)是与模型结构无关的算法,适合通用化,分为两部分:meta-train和finetune。
meta-train有一个初始化θ,进行两次采样,场景采样和场内样本采样。第一步,场景采样在这一轮采样过程中,全体样本有十万甚至上百万的task,会从上百万的task中采样出n个task;第二步,在每个场景上,为这个场景采样batchsize个样本,把batchsize个样本分为两部分,一部分是Support Set,另一部分是Query Set;用Support Set 使用随机梯度下降法更新每个场景的θ;第三步,再用Query Set为每个场景计算loss;第四步,把所有的loss相加,梯度回传给θ;整体进行多轮计算,直到满足终止条件。
其中,Support Set可以理解为训练集合,Query Set理解为validation集合。
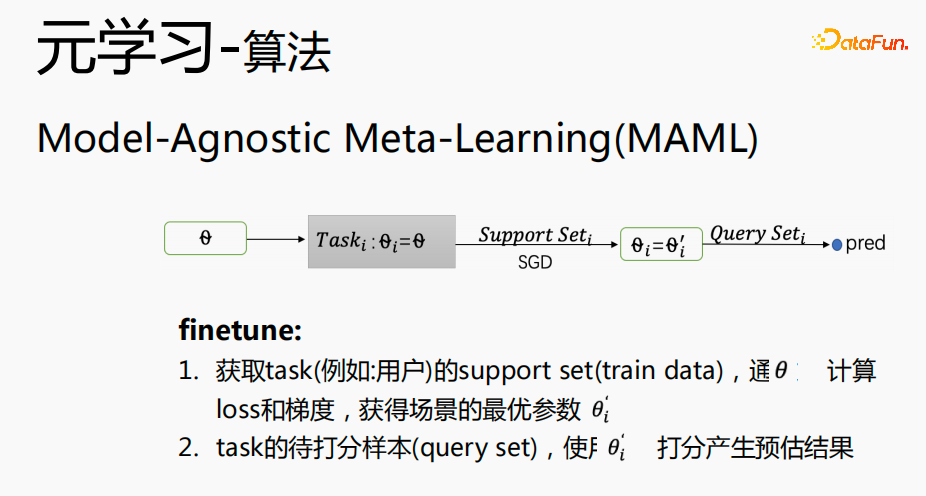
Finetune过程和meta-train过程很接近,θ放在具体的场景中,获取场景的support set,利用梯度下降法(SGD),获得场景的最优参数 ;使用
 对task场景待打分的样本(query set)产生预估结果。
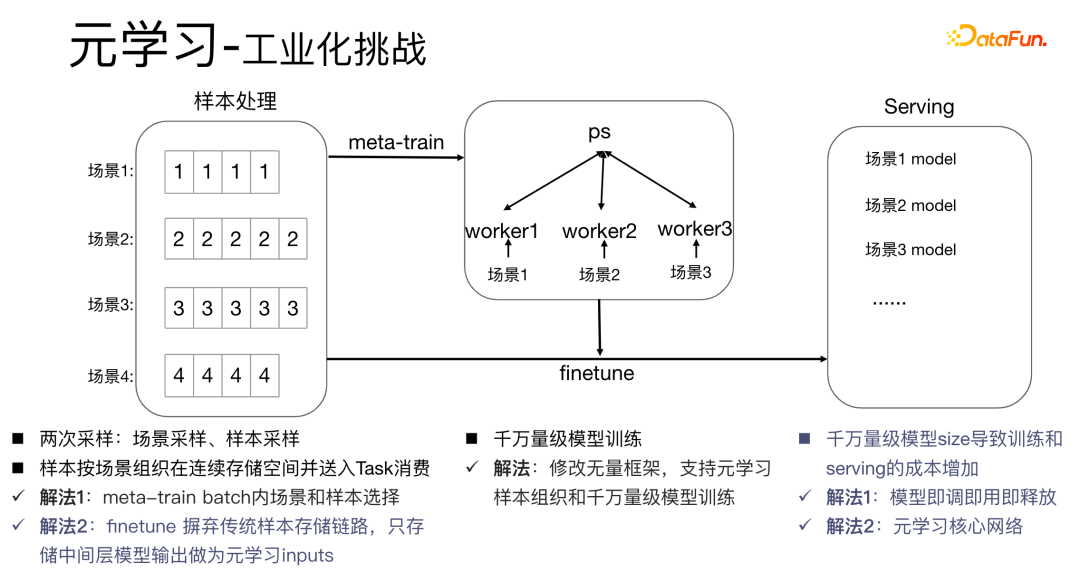
将元学习算法应用在工业化的场景中会有比较大的挑战:元学习算法的meta-train过程涉及到两次采样,场景采样和样本采样。对于样本而言,需要把样本组织好,同时按照场景的顺序存储下来并进行处理,同时需要一个字典表来存储样本和场景的对应关系,这个过程十分消耗存储空间和计算性能,同时需要将样本放到worker中进行消费,这对工业化场景具有非常大的挑战。
我们有如下的解决方法:
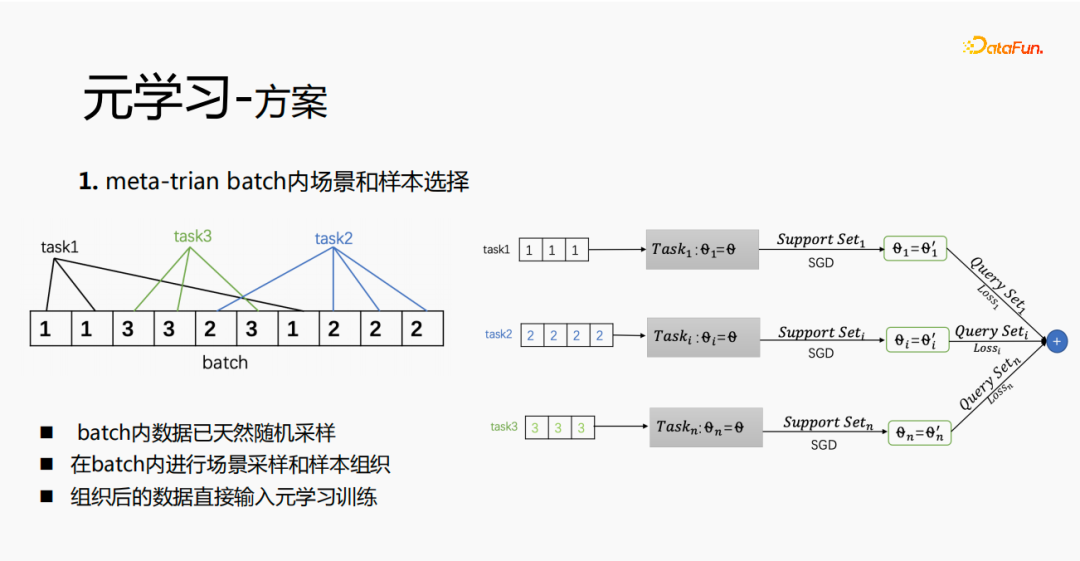
首先在meta-train中实现batch内场景和样本的选择,每个batch内会有多条数据,每个数据属于一个task。在一个batch内,将这些数据按照task抽取出来,抽取出来的样本放到meta-train训练过程中,这样就解决了需要独立维护一套场景选择和样本选择的处理链路的问题。
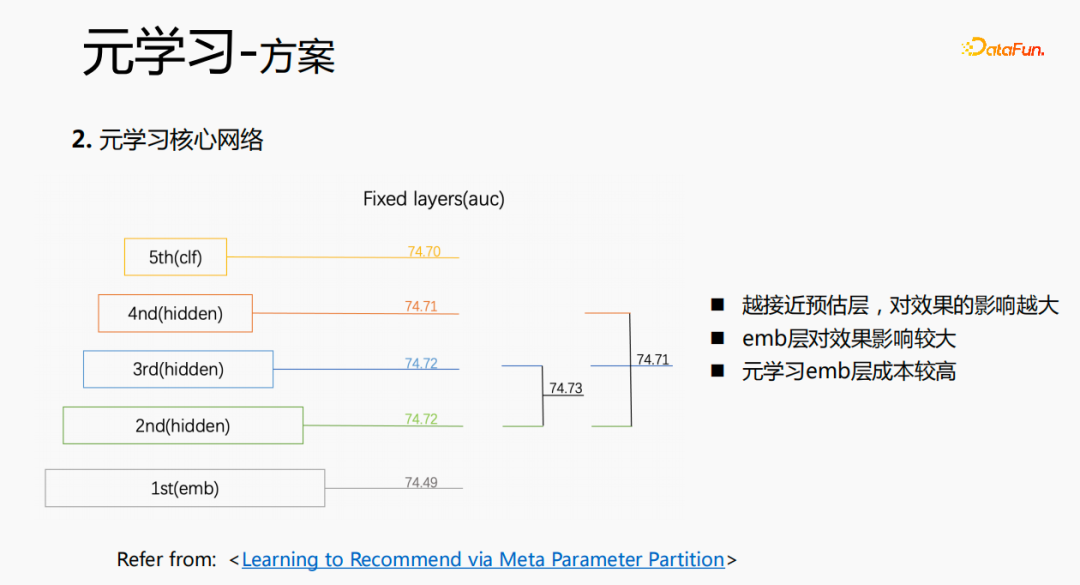
通过实验调研以及阅读论文,我们发现,在fine-tune以及在元学习过程中,越接近预估层,对模型的预估效果影响越大,同时emb层对模型的预估效果影响较大,中间层对预估效果没有很大的影响。所以我们的思路是,元学习只选取离预估层较近的参数就可以,从成本上考虑,emb层会导致学习的成本增加,对emb层就不进行元学习的训练了。
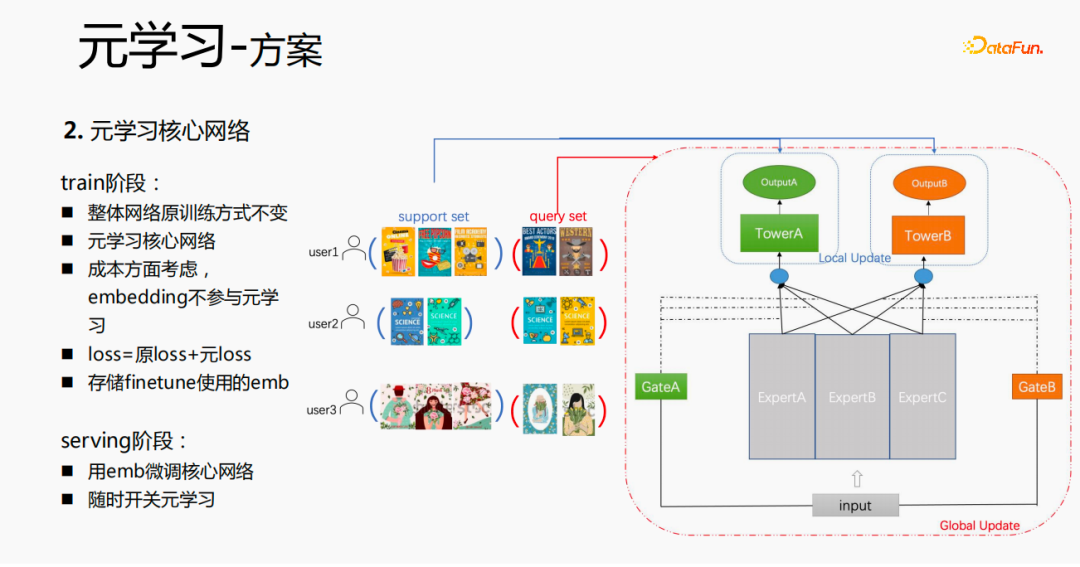
整体训练过程,如上图中的mmoe的训练网络,我们对tower层的参数进行学习,其他场景的参数还是按照原始的训练方式来学习。以user为维度来进行样本的组织,每一个用户有自己的训练数据,把训练数据分为两部分,一部分是support set,一部分是query set。在support set中,只学习local侧的内容进行tower update,进行参数训练;再用query set数据对整体的网络进行loss计算后梯度回传,来更新整个网络的参数。
因此,整个训练过程是:整体网络原训练方式不变;元学习只学习核心网络;从成本方面考虑,embedding不参与元学习;loss=原loss+元loss;fintune时,把emb进行存储。serving过程,用emb微调核心网络,同时可用开关来控制元学习随开随关。
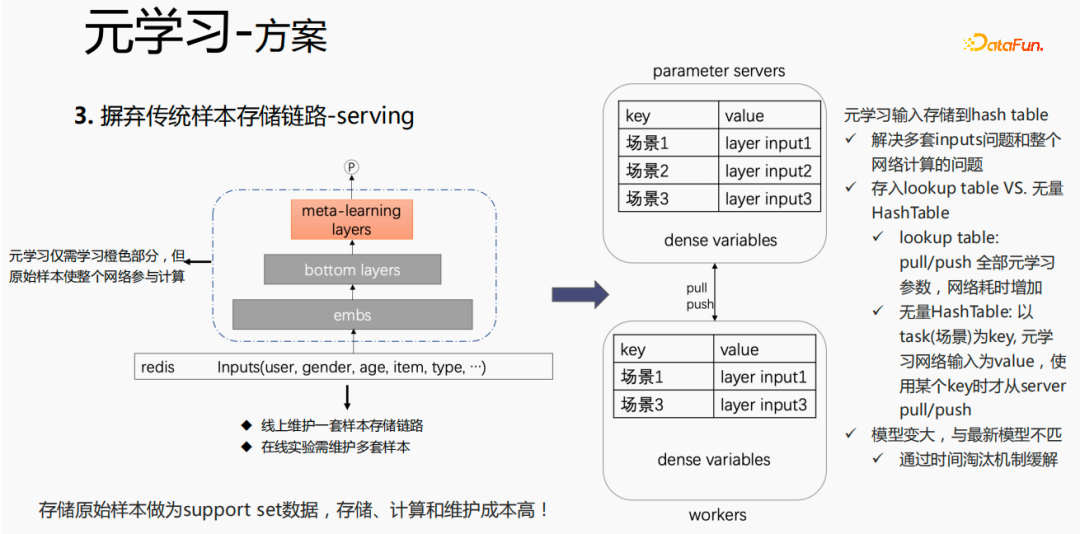
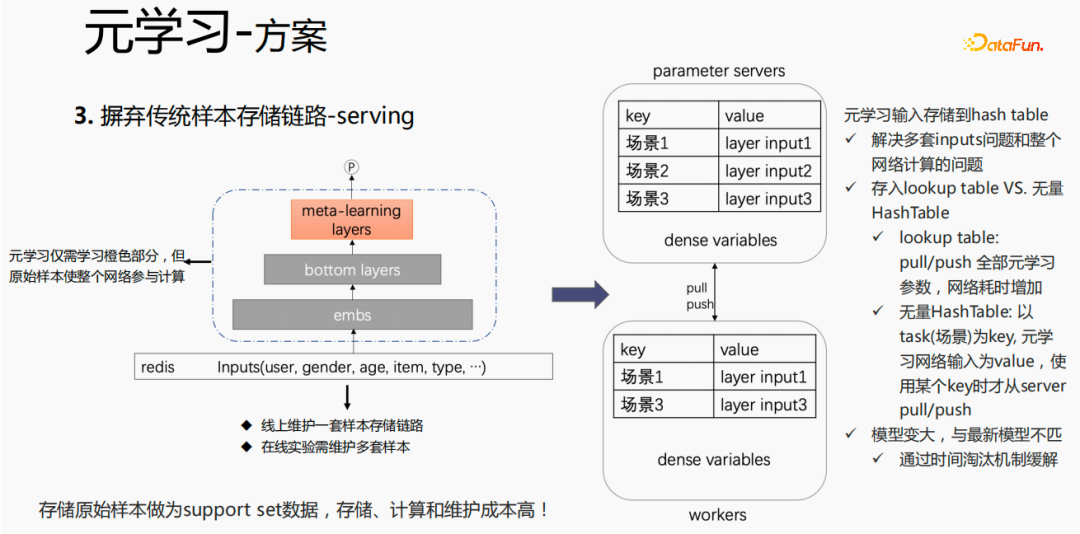
对于传统的样本存储方式,如果在serving过程,直接进行finetune,会存在较严重的问题:需要在线上维护一套样本存储链路;多套在线实验需要维护多套样本。同时,finetune过程,用原始样本进行finetune,样本要经过emb层、bottom layers层以及meta-learning层,但是元学习在serving过程仅需要学习meta-learning layers,不关心其他部分。我们考虑在serving过程,仅保存meta-learning input 存到模型中,这样就能节省样本链路的维护,同时达到一定的效果,如果只存emb这一部分,可节省该部分的计算成本和维护成本。
我们采用如下的方法:
把存储放到模型的lookup table中,lookup table 会被认为是一个 dense 的 variables,存储在ps中,所有的参数都会pull到worker 上,更新时,也会push到所有的 variables ,这样会增加网络的耗时。另一种方式是使用无量HashTable,HashTable是以key、value的形式存储,key是场景,value是meta layer的input,这样做的好处是,只需将所需要的场景的input layer从ps上进行push或者pull,整体会节省网络的耗时,所以我们采样该方法来存储meta layer 的input。同时,如果将 meta-learning layers 存储到模型中,会使得模型变大,也会遇到过期的问题,导致和目前的模型不匹配,我们使用时间淘汰极致来解决该问题,即淘汰掉过期embedding,这样既使得模型变小,也能解决实时性的问题。
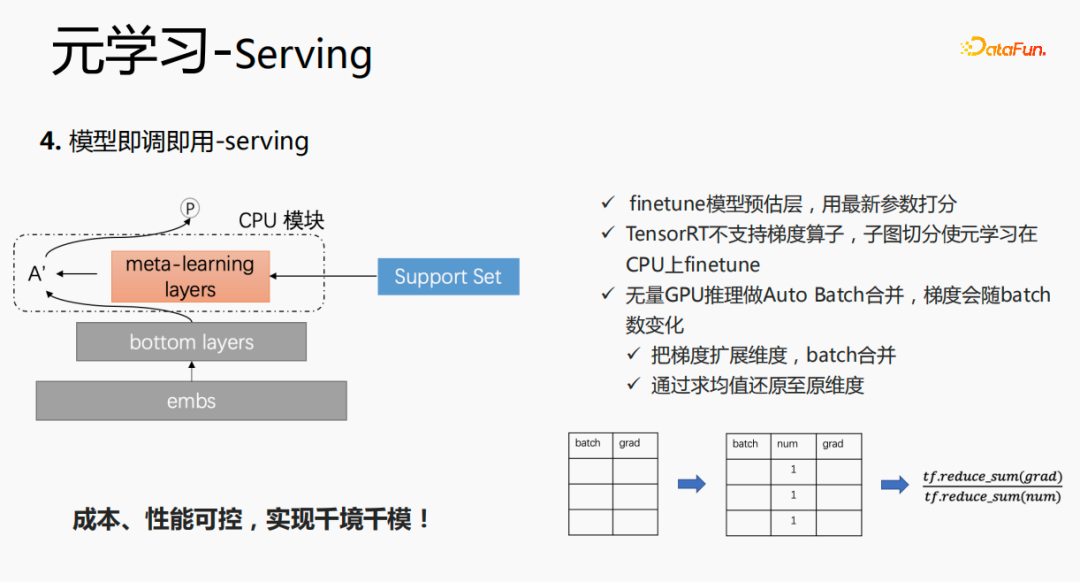
这个模型在 serving 阶段,会使用embedding,embedding输入到bottom layers,打分时,并不像原始的方式一样,而是通过meta-learning layers拿到support set 中的数据,将该层的参数更新,使用更新后的参数进行打分。这个过程在GPU上无法进行计算,因此我们在CPU上执行该过程。同时,无量GPU推理做了Auto Batch合并,将多个请求进行合并,合并后的请求在GPU上进行计算,这样处理,梯度会随着batch的增加而变化,针对该问题,我们在batch和grad的基础上,增加一个num维度,计算梯度时,将grad进行相加,按照num 进行处理后,保持梯度的稳定性。最终实现成本和性能可控,同时实现了千境千模。
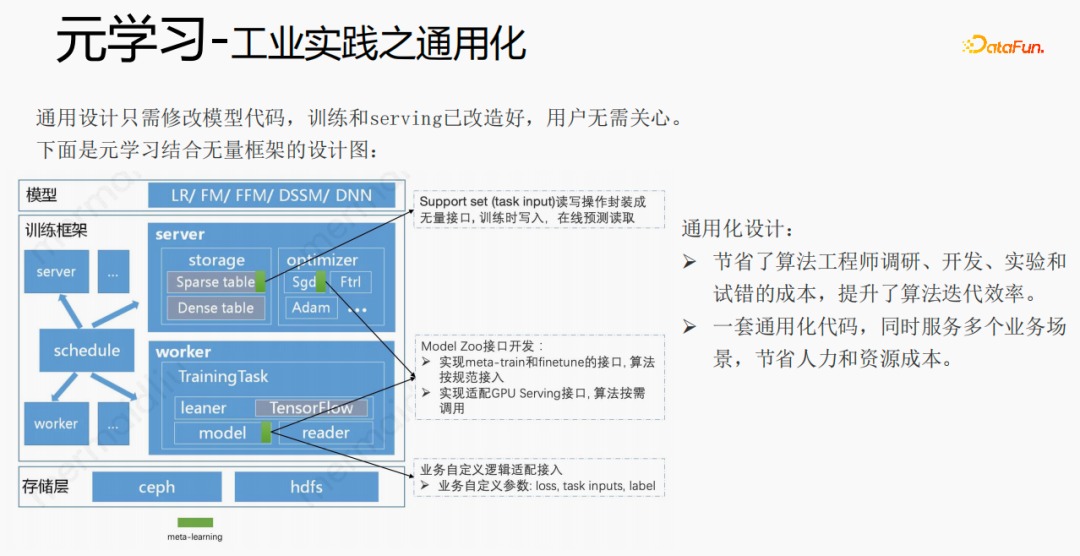
借助框架、组件将元学习通用化,用户接入时,只需修改模型代码,用户无需关心训练和serving,只需调用我们已经实现好的接口,例如:support set读写接口、meta-train和finetune实现接口以及GPU serving适配接口等。用户只需传入loss、task inputs、label等业务相关参数。这样设计,节省了算法工程师调研、开发、实验和试错的成本,提升了算法的迭代效率;同时,通用化的代码,可服务多个业务场景,节省人力和资源成本。
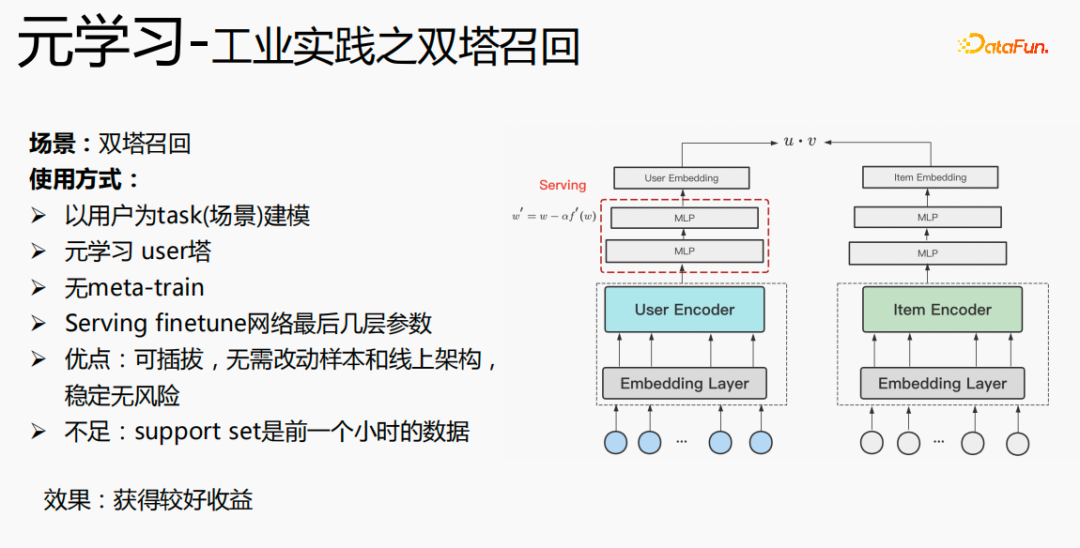
元学习在双塔召回场景下的使用,是以用户为维度进行建模,包括user塔和item塔。模型的优点是:可插拔,无需改动样本和线上架构,稳定无风险;缺点是support set是前一个小时的数据,存在实时性的问题。
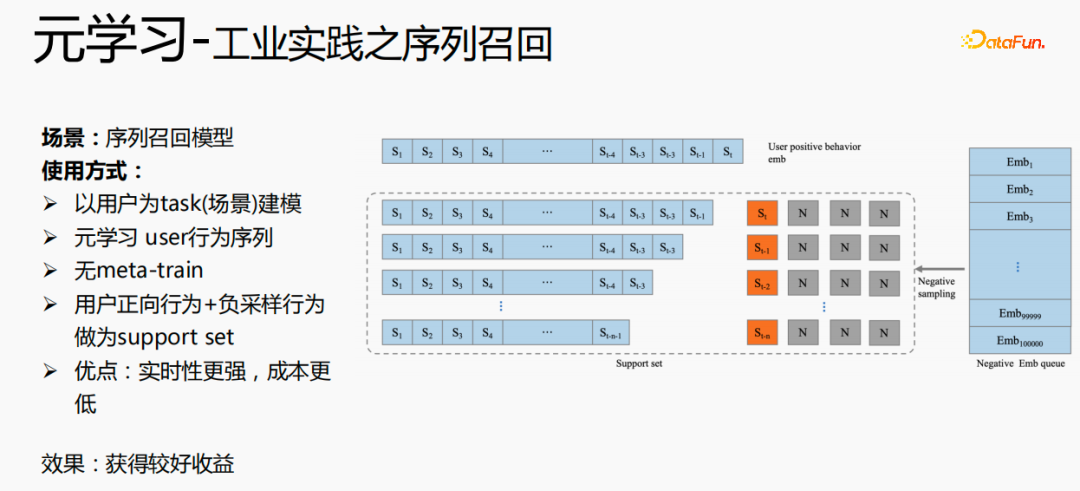
元学习的另一个应用场景是在序列召回场景,该场景是以用户为场景来建模,以用户的行为序列作为support set,用户行为序列只有正样本,我们会维护一个负样本队列,采样队列中样本做为负样本,并拼接上正样本作为support set。这样做的好处是:实时性更强,成本更低。
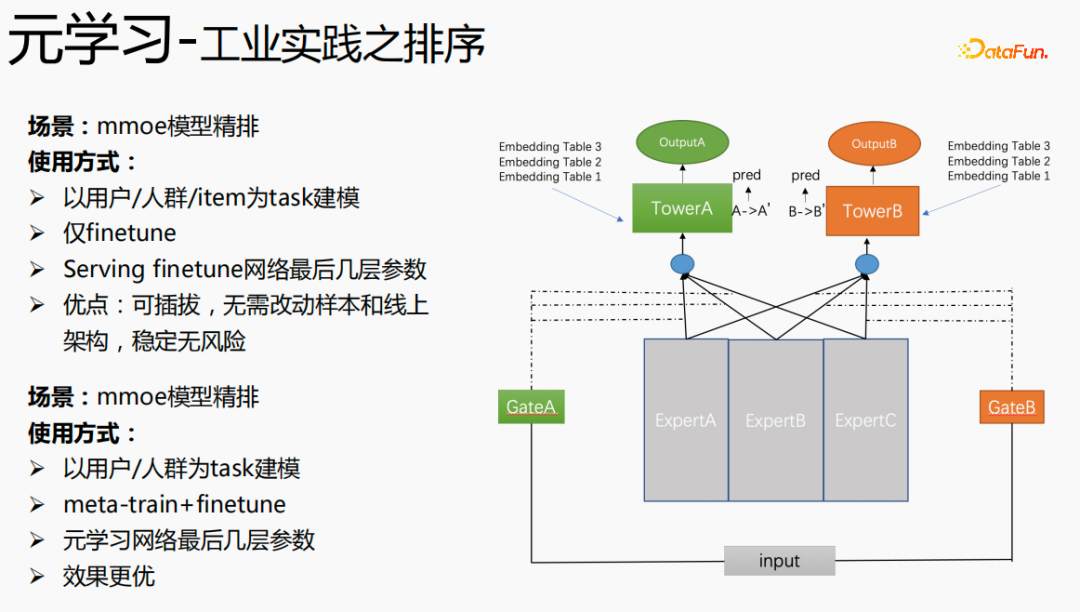
最后,元学习也应用在排序场景中,如上图中的mmoe精排模型,实现方式有两种:仅 使用finetune,以及同时使用meta-train和finetune。第二种实现方式效果更优。
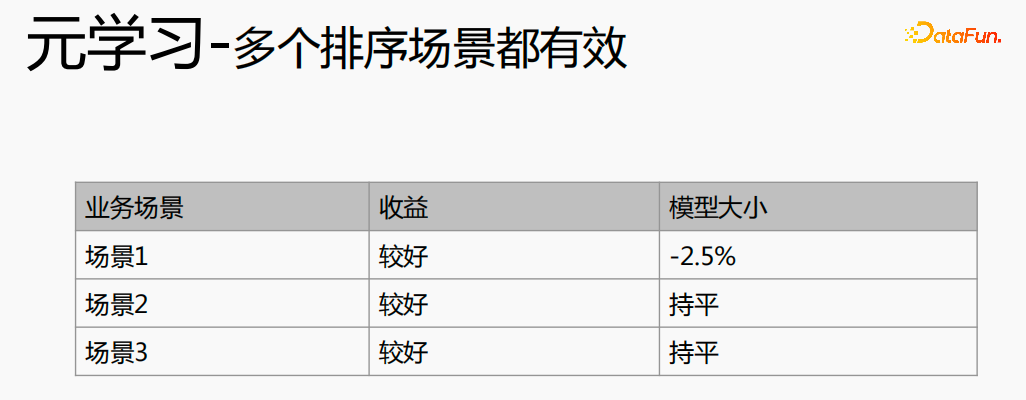
元学习在不同的场景中都取得了较好的收益。
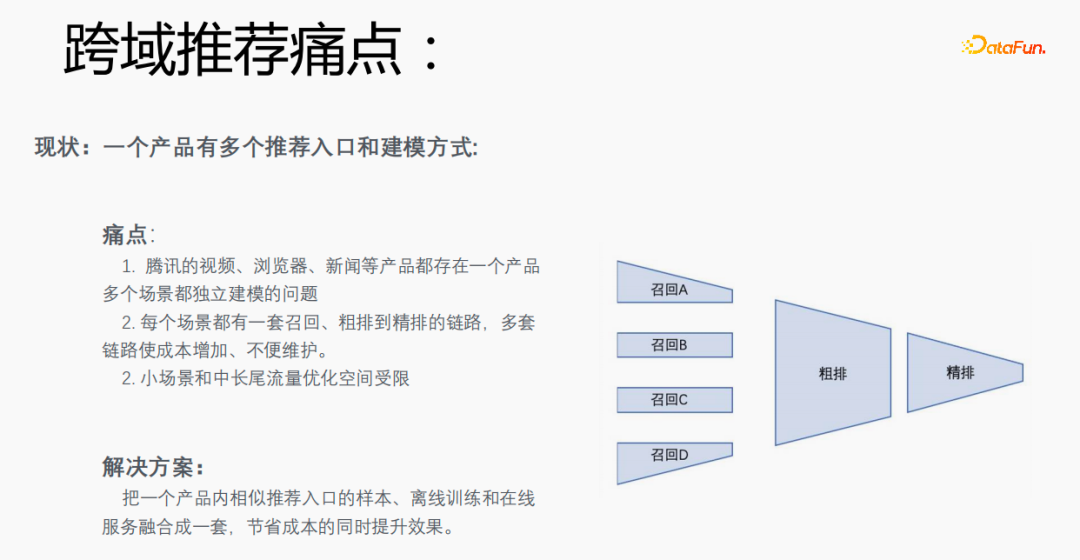
每个场景有多个推荐的入口,需要为每个场景都建立一套召回、粗排到精排的链路,成本较高。尤其小场景和中长尾流量数据稀疏,优化空间受限。我们能否将一个产品内相似推荐入口的样本、离线训练和在线服务融合成一套,达到节省成本并提升效果的目的。
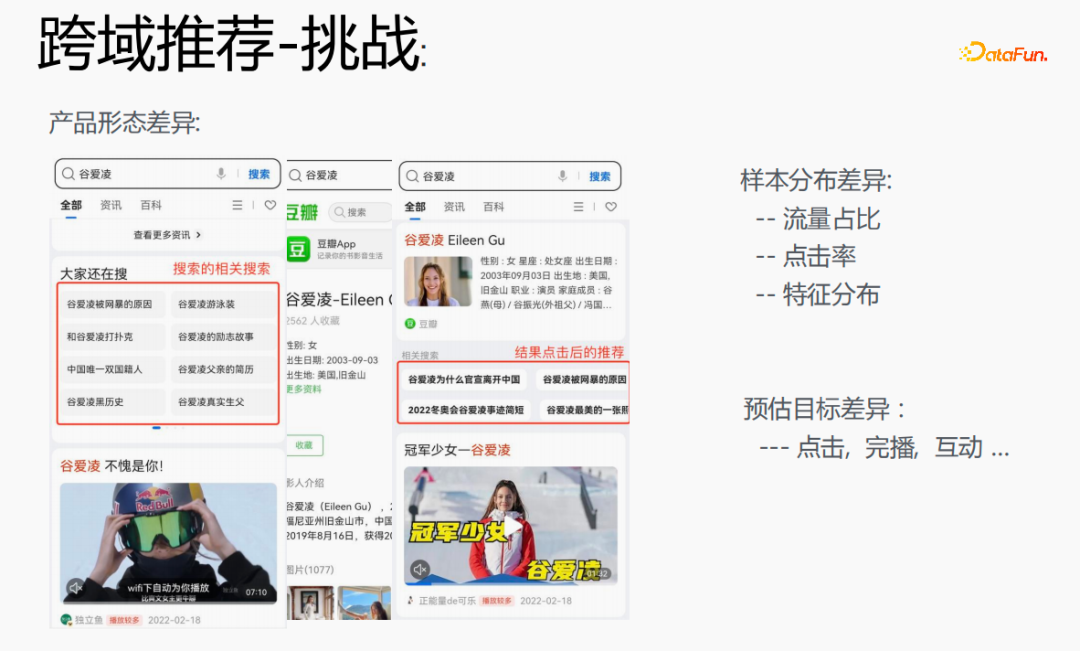
但是,这样做也存在一定的挑战。在浏览器上搜索谷爱凌,会出现相关搜索词,点击具体的内容并返回后,会出现结果点击后的推荐,这两种的流量占比、点击率以及特征分布的差异都比较大,同时在预估目标上也有差异。
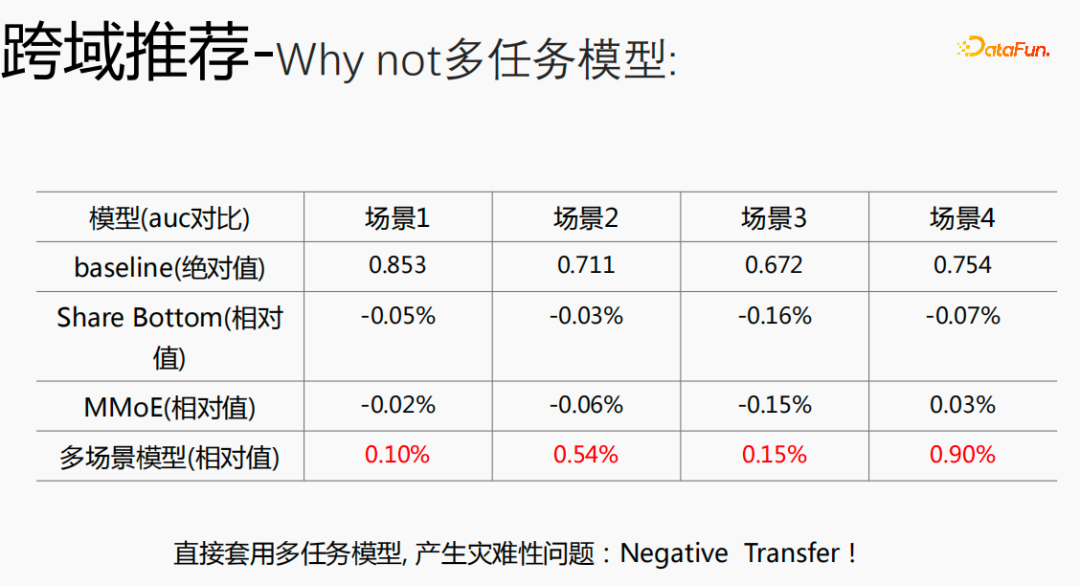
如果将跨域的模型使用多任务模型,就会产生比较严重的问题,并不能拿到比较好的收益。
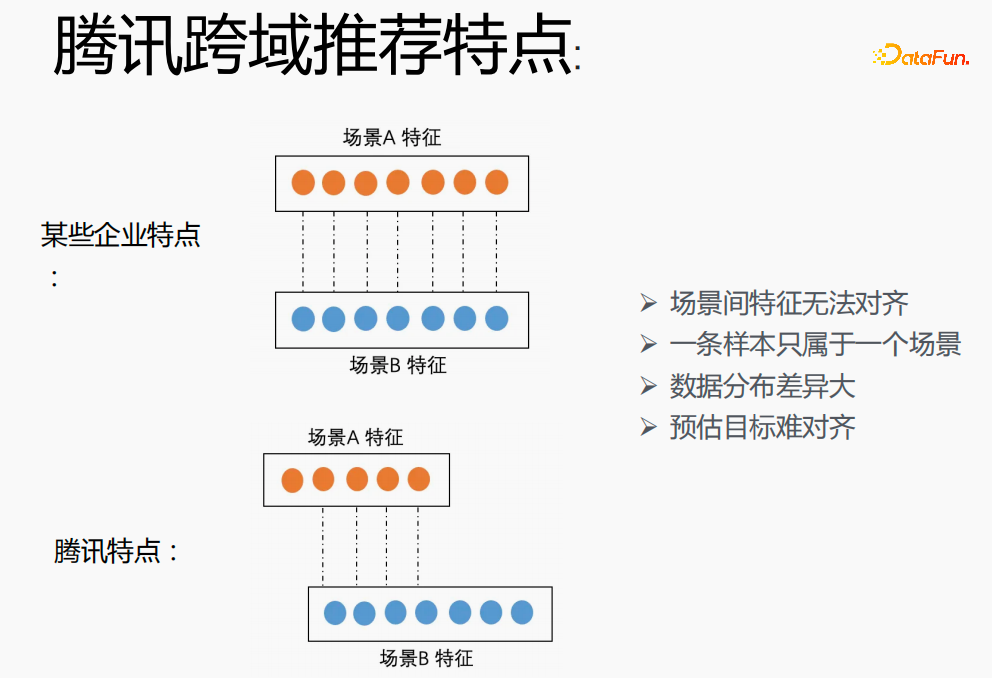
在腾讯实现跨场景建模具有较大挑战。首先在其他企业,两个场景的特征能够一一对应,但在腾讯的跨域推荐领域两个场景的特征无法对齐,一条样本只能属于一个场景,数据分布差异大,预估目标难对齐。
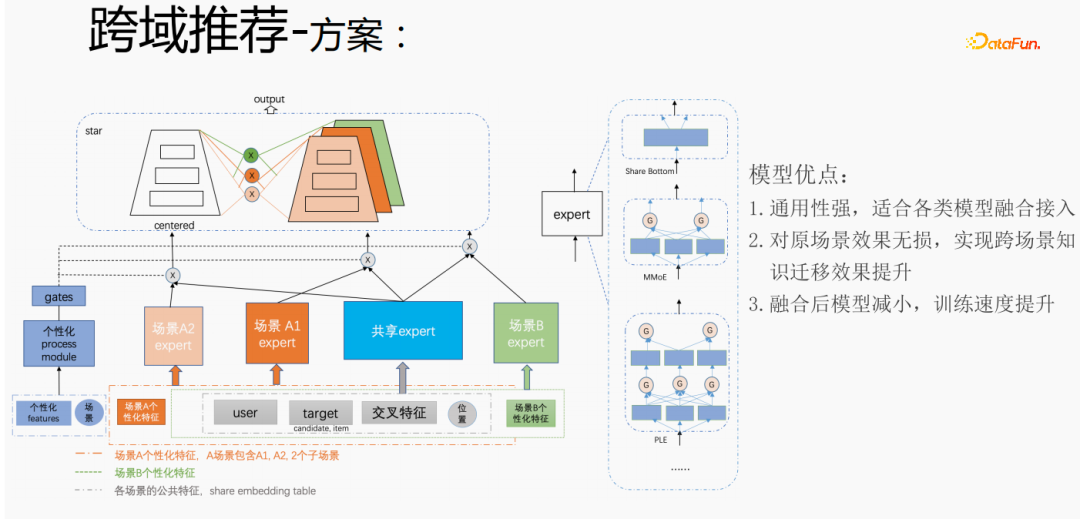
针对腾讯跨域推荐场景的个性化需求,采用上述方式进行处理。对于通用特征进行shared embedding,场景个性化的特征自己独立 embedding空间,在模型部分,有共享的expert和个性化的expert,所有的数据都会流入共享的expert,每个场景的样本会数据各自的个性化expert,通过个性化gate将共享expert和个性化expert融合,输入到tower,用star的方式来解决不同场景的目标稀疏的问题。对于expert部分,可以采用任意的模型结构,例如Share bottom、MMoE、PLE,也可以是业务场景上的全模型结构。该方式的优点是:模型的通用性强,适合各类模型融合接入;由于可以直接将场景expert迁移,对原场景效果无损,实现跨场景知识迁移效果提升;融合后模型减小,训练速度提升,同时节省成本。
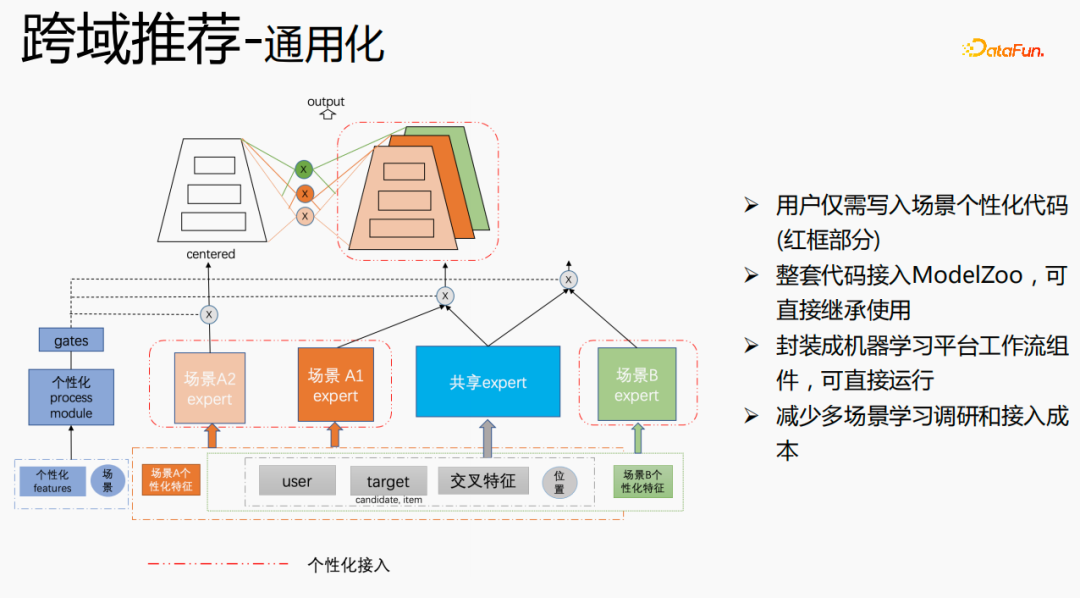
我们进行了通用化建设,红色部分是需要个性化接入的内容,例如:个性化特征、个性化模型结构等,用户只需写入个性化的代码即可。其他部分,我们已经将整套代码接入ModelZoo,可直接继承使用,并将其封装成机器学习平台工作流组件,可直接运行,该方式减少了多场景学习调研和接入成本。
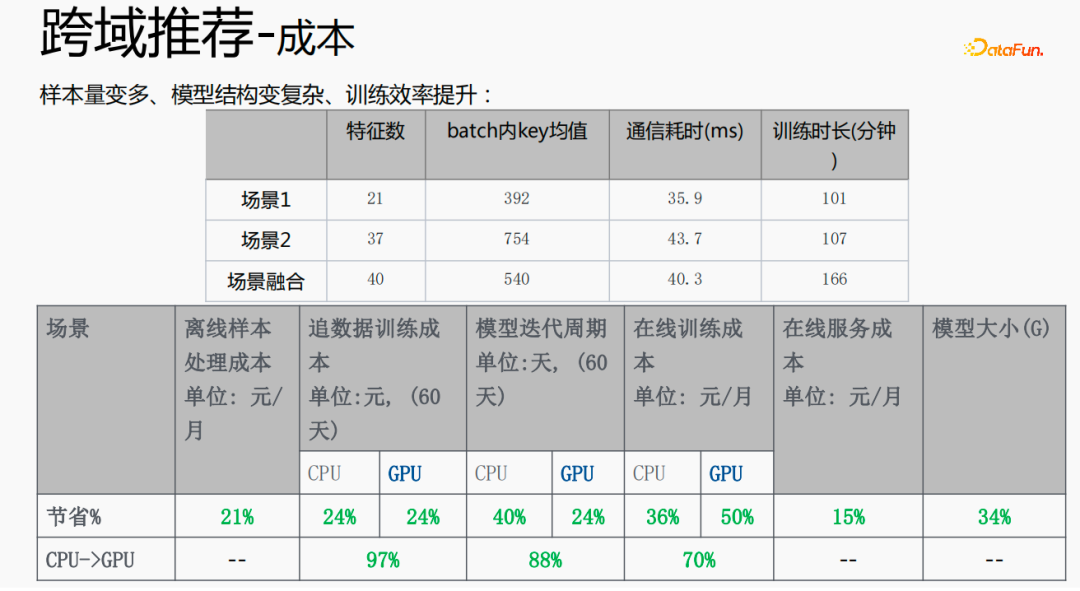
这种方式使样本量变多,模型结构变得复杂,但效率反而提升了。原因如下:由于一些特征是共享的,融合后的特征数比两个场景特征数的加和要少;由于shared embedding的功能,batch内key均值,比两个场景的加和要小;减小了从server端pull或push的时间,从而节省了通信耗时,整体降低了训练耗时。
多场景的融合能使整体成本减少:离线样本处理,能够减少21%的成本;采用CPU追数据,会节省24%的成本,同时模型的迭代时间也会减少40%,在线训练成本、在线服务成本、模型大小都会降低,所以使全链路的成本降低了。同时,将多个场景的数据融合在一起,更适合GPU计算,将两个单场景的CPU融合到GPU上,节省的比例会更高。
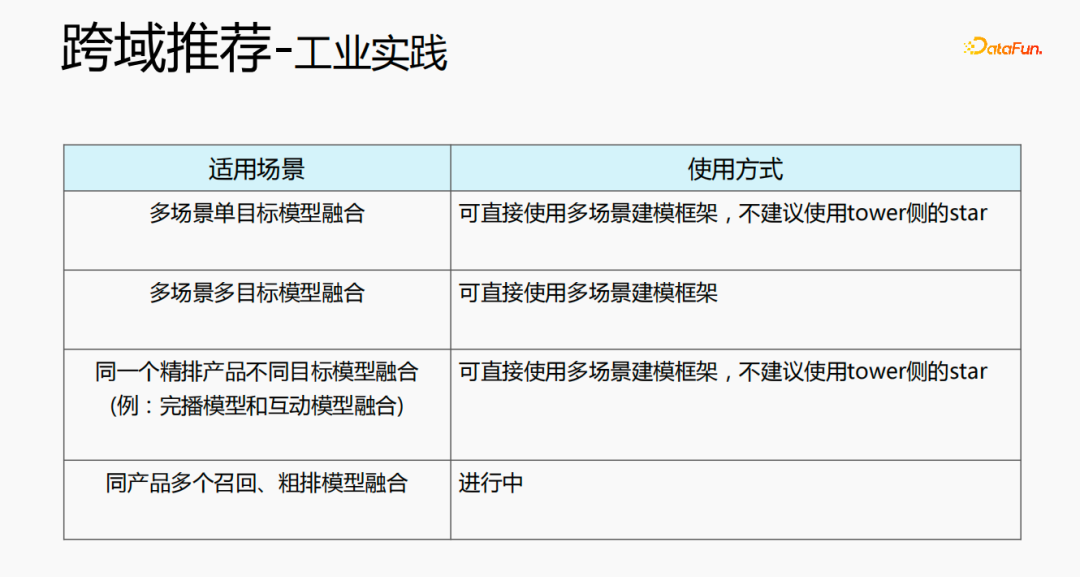
跨域推荐可通过多种方式来使用。第一种,多场景单目标的模型结构,可直接使用多场景的建模架构,不建议使用tower侧的star;第二种,多场景多目标的融合,可直接使用多场景的建模框架;第三种,同一个精排产品,不同目标模型融合,可直接使用多场景建模框架,不建议使用tower侧的star;最后一种,同产品多个召回、粗排模型融合,目前正在进行中。
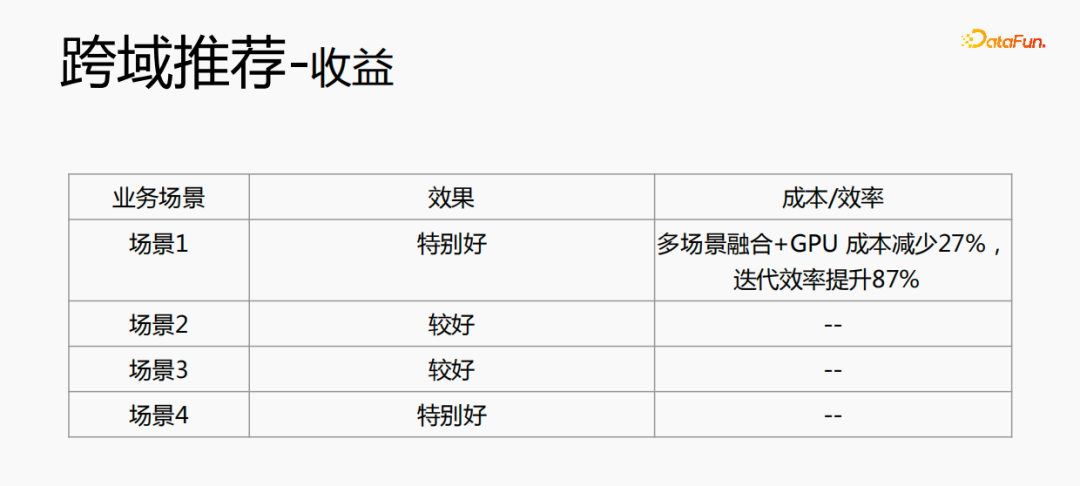
跨域推荐不仅在效果上有提升,在成本上也节省了很多。
以上就是腾讯TRS之元学习与跨域推荐的工业实战的详细内容,更多请关注其它相关文章!
# 较高
# 值米营销推广平台
# 国内seo搜索引擎
# 咸宁外包网站推广公司
# 市场营销推广怎么做
# 南开企业网站建设服务
# 汽车网站建设实例分享
# 新郑网站营销推广
# 中阳网站推广趋势
# 罗湖区seo价格
# 国内关键词布局排名前十
# 算法
# 也会
# 是在
# 链路
# 可直接
# 多场
# 最优
# 只需
# 多个
# 腾讯
# 元学习
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
揭秘AI数字人语录:抖音AI小和尚、老者语录能赚钱吗?
0代码微调大模型火了,只需5步,成本低至150块
扎克·施奈德新片《月球叛军》曝剧照 机器人首度现身
B站内测 AI 搜索功能,输入“?”即可体验
沐曦首款AI推理GPU亮相:INT8算力达160TOPS!
微软AR/VR专利提出使用时间复用谐振驱动产生双极性电源
水路两栖艇、消防灭火机器人……这个展览“黑科技”抢眼
马斯克预测:特斯拉全自动驾驶将在今年实现 对AI深度变化感到担忧
创作音乐/音频的Meta开源AI工具AudioCraft,让用户通过文本提示实现
人工智能写作检测工具不靠谱,美国宪法竟被认为是机器人写的
智能公司为何纷纷投身机器人领域?
Meta推出VR订阅服务Quest +:每月免费玩两款游戏,7.99美元/月
电池比 Air 2S 大 20%,大疆 Air 3 无人机现身 FCC
pixivFANBOX 更新运营规则,禁止通过外链绕开 AI 生成禁令
比尔盖茨:AI确实存在风险,但可控
Valve Index VR 头显销量下滑,上市四年的长青树渐失光彩
ChatGPT只讲这25个笑话!实验上千次有90%重复,网友:幽默是人类最后的尊严
即将到来:AI婚纱设计软件实际测试,人工智能即将开创婚纱设计新纪元
清华系面壁智能开源中文多模态大模型VisCPM :支持对话文图双向生成,吟诗作画能力惊艳
全面拥抱大模型浪潮,ISC 2025打造全球首场AI数字安全峰会
人才智能平台转型中的人工智能的关键角色
字节、网易相继入局,AI之后大厂又找到下一个风口?
第二届光合组织AI解决方案大赛赛果揭晓
如何提高集群协作效率?中外团队合作研发基于均值偏移的机器人队形控制策略
WHEE功能介绍
卫星通信牵引物联网竞争升维,模组厂商如何决胜百亿市场?
丰田汽车研究院推出生成式人工智能汽车设计工具
下一个前沿:量子机器学习和人工智能的未来
WPS AI 官网上线:可申请体验官资格,支持 Windows、安卓端下载
微幼科技晨检机器人:幼儿园健康保障的新伙伴
IBM与NASA联手开源地理空间AI基础模型,促进气候科学领域进步
特斯拉门店可能启动机器人卖车?也许不是你想的那样
OpenAI限制网络爬虫访问以保护数据免被用于AI模型训练
编程已死,AI 当立?教授公开“唱反调”:AI 还帮不了程序员
Unity发布Sentis和Muse AI工具,助力创作游戏和3D内容
苹果头显降临,AI虚拟人的救星还是流星?
搭载星火认知大模型 讯飞听见智慧屏开启AI办公新体验
V社谈AI制作游戏被ban:为确保开发者有素材所有权
人工智能驱动艺术,打开达利的超现实想象
能走、能飞、能游泳,科学家打造全能 M4 机器人
掌阅科技申请阅爱聊商标 掌阅科技申请AI相关商标
大型无人机FH-98国内首次夜航转场成功
Unity 推出面向开发者的 AI 软件市场 AI Hub,股价飙涨 15%
Hugging Face发布了基于NASA卫星数据构建的AI地理空间基础模型
无人机巡检方案是什么,该如何选择适合的巡检方案
华为将于 7 月发布面向 AI 大模型的新款存储产品
定义人工智能的十个关键术语
360发布认知型通用大模型“360智脑4.0” 全面接入360全家桶
食品分销跨国企业Sysco CIDO:我们的增长秘诀是以IT为中心
支持跨语言、人声狗吠互换,仅利用最近邻的简单语音转换模型有多神奇
2023-07-15

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
