多模态大模型集成了检测分割模块后,抠图变得更简单了!
我们的模型可以通过自然语言描述来快速标注要寻找的物体,并提供文字解释,让您轻松完成任务。
新加坡国立大学NExT++实验室与清华刘知远团队合作开发的全新多模态大模型,为我们提供了强大的支持。这个模型的背后是经过精心打造的,它能够在解谜过程中为玩家们提供全面的帮助和指导。它结合了多种模态的信息,为玩家们呈现出全新的解谜方法和策略。这个模型的应用将为玩家们
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
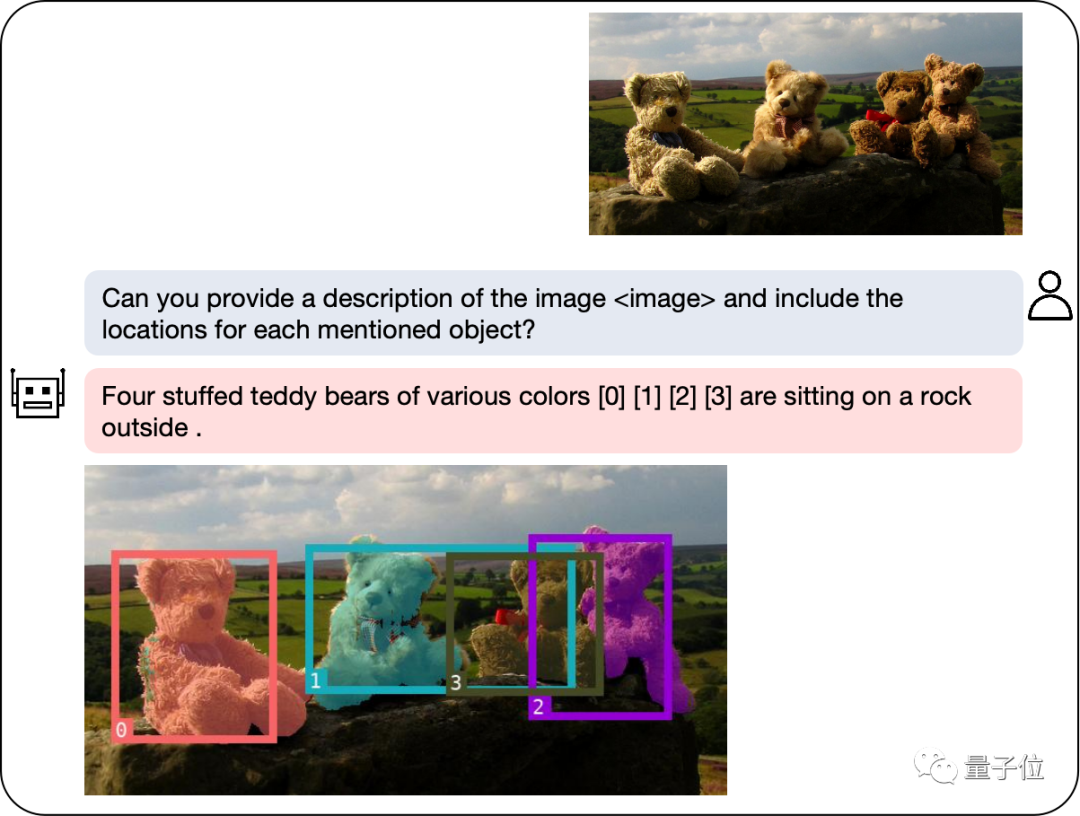
随着GPT-4v的推出,多模态领域迎来了一系列新模型,如LLaVA、BLIP-2等等。这些模型的出现在提升了多模态任务的性能和效果方面做出了巨大贡献。
为了进一步提升多模态大模型的区域理解能力,研究团队开发了一个名为NExT-Chat的多模态模型。该模型具备同时进行对话和检测、分割的能力。
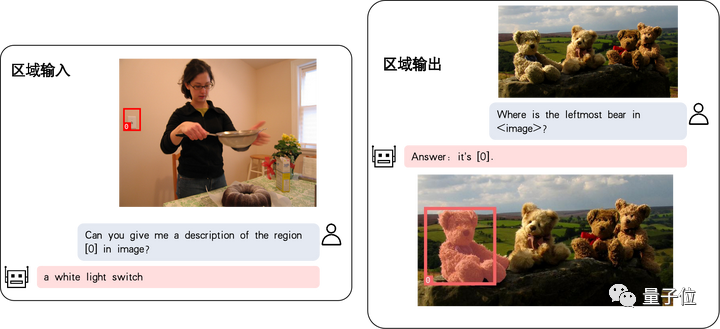
NExT-Chat的最大亮点是其多模态模型中引入了位置输入和输出的能力。这一特点使得NExT-Chat在交互中能够更加准确地理解和回应用户的需求。通过位置输入,NExT-Chat可以根据用户所在的地理位置提供相关的信息和建议,从而提升用户体验。而通过位置输出,NExT-Chat可以将特定地理位置的相关信息传达给用户,帮助他们更好
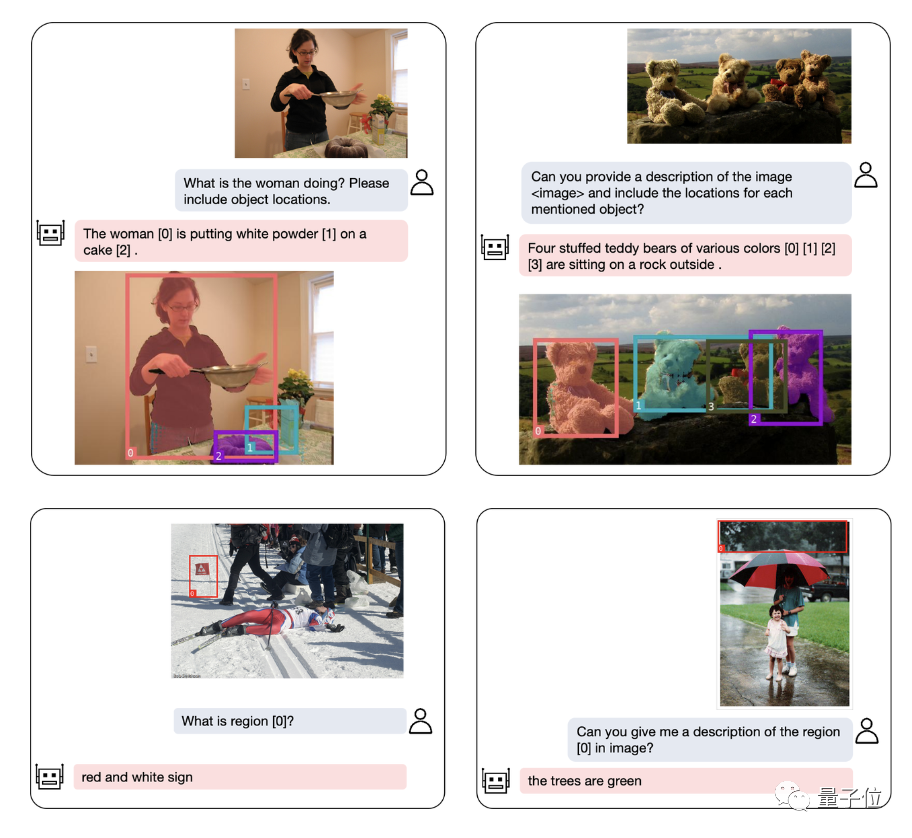
其中,位置输入能力是指根据指定的区域回答问题,而位置输出能力则是指定位对话中提及的物体。这两种能力在解谜游戏中非常重要。
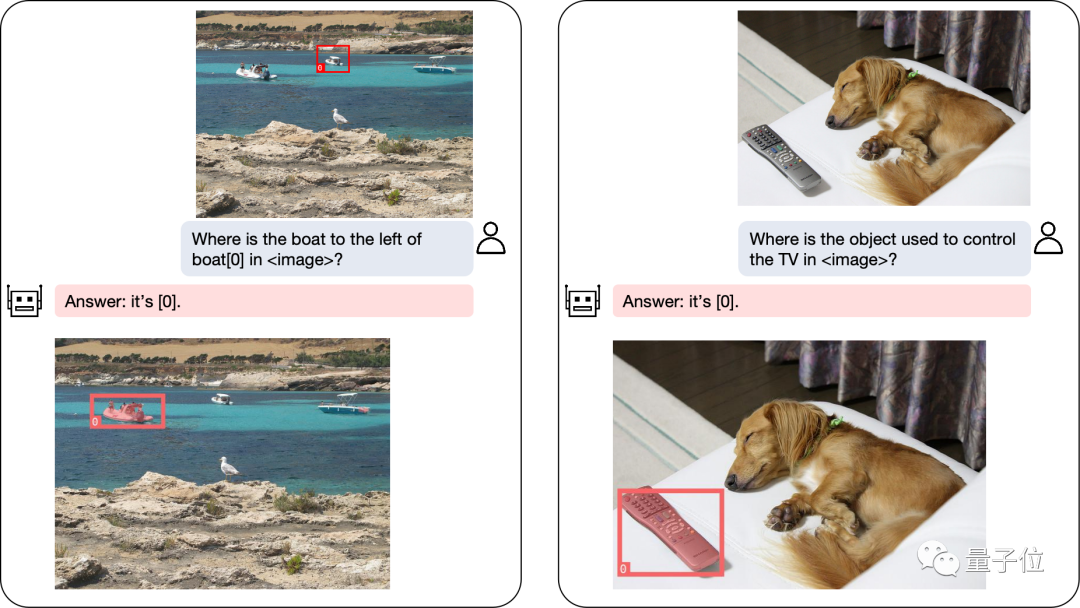
即使是复杂的定位问题,也能迎刃而解:
除了物体定位,NExT-Chat还可以对图片或其中的某个部分进行描述:
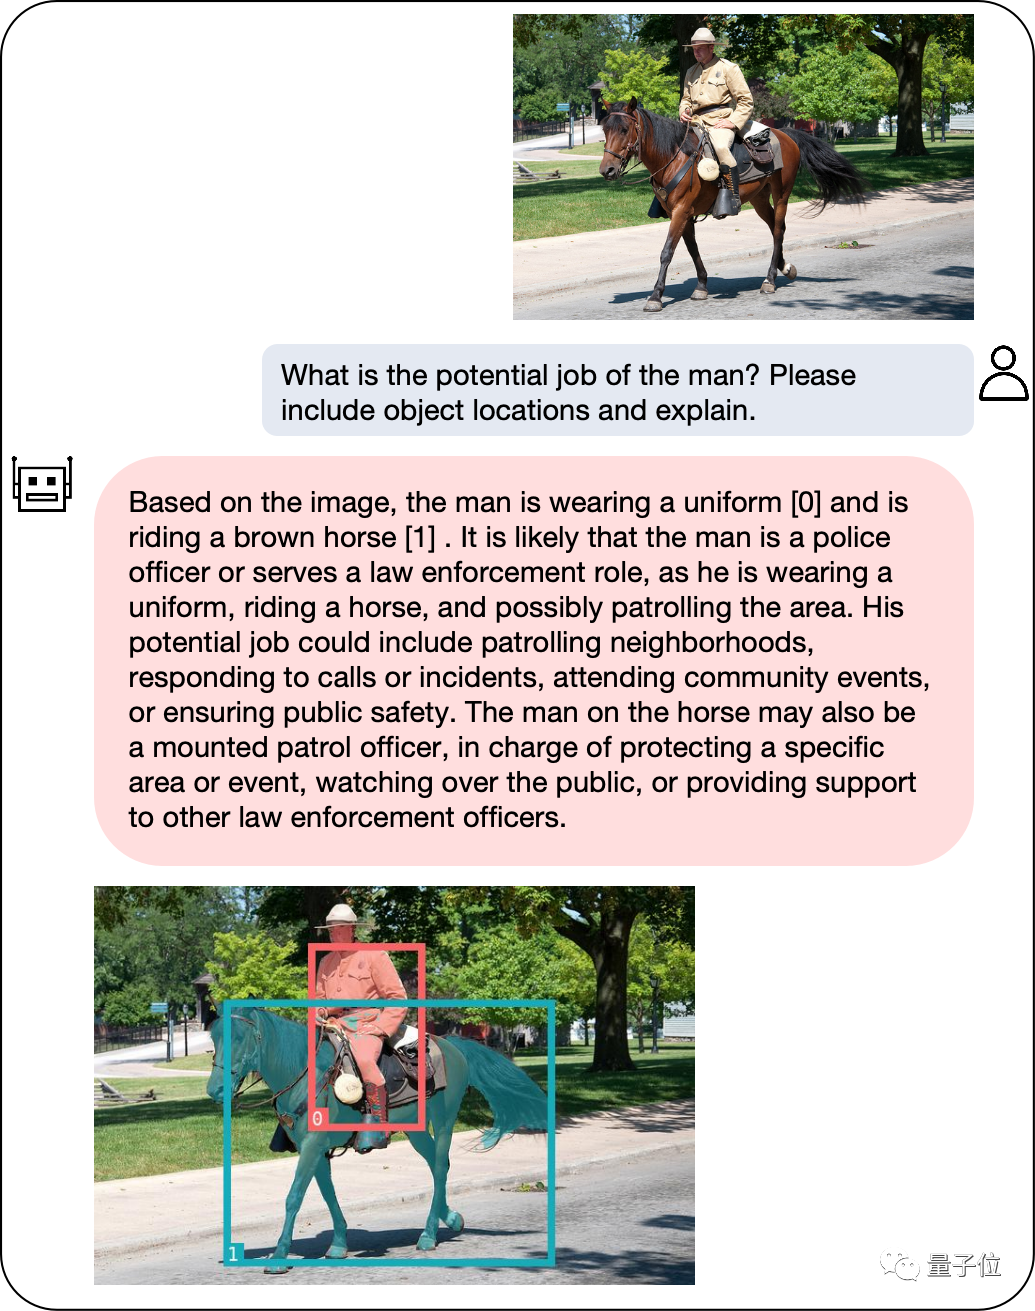
分析完图像的内容之后,NExT-Chat可以利用得到的信息进行推理:
为了准确评估NExT-Chat的表现,研究团队在多个任务数据集上进行了测试。
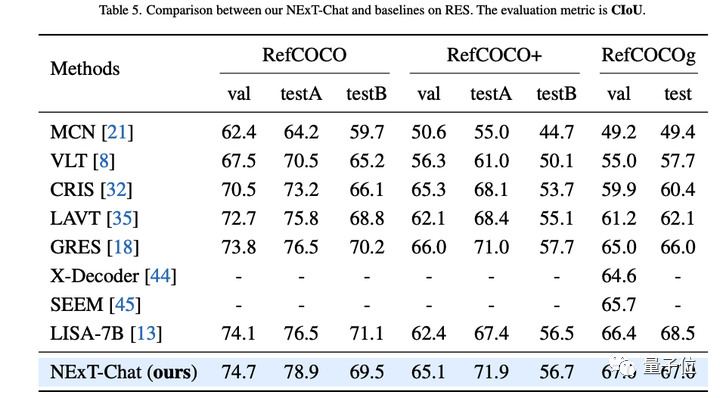
作者首先展示了NExT-Chat在指代表达式分割(RES)任务上的实验结果。
虽然仅仅用了极少量的分割数据,NExT-Chat却展现出了良好的指代分割能力,甚至打败了一系列有监督模型(如MCN,VLT等)和用了5倍以上分割掩模标注的LISA方法。
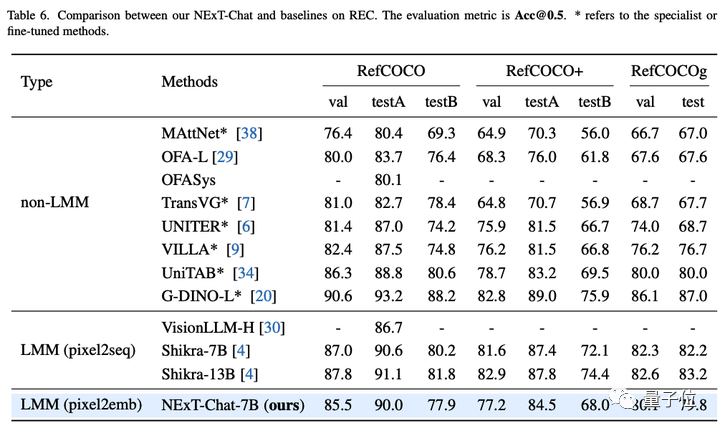
接着,研究团队展示了NExT-Chat在REC任务上的实验结果。
如下表所示,相比于相当一系列的有监督方法(如UNITER),NExT-Chat都可以取得更优的效果。
一个有意思的发现是NExT-Chat比使用了类似框训练数据的Shikra效果要稍差一些。
作者猜测,这是由于pix2emb方法中LM loss和detection loss更难以平衡,以及Shikra更贴近现有的纯文本大模型的预训练形式导致的。
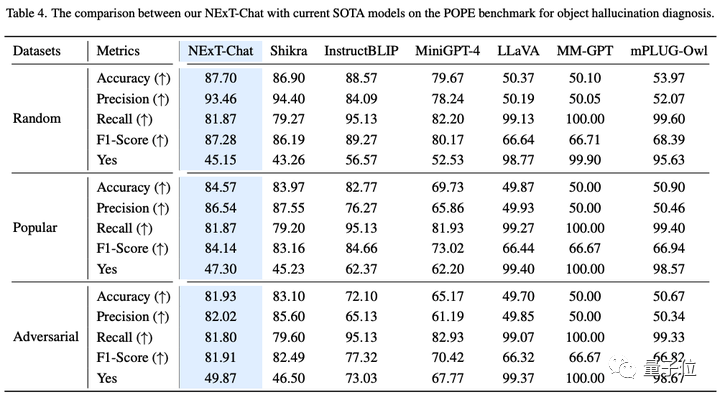
在图像幻觉任务上,如表3所示,NExT-Chat可以在Random和Popular数据集上取得最优的准确率。
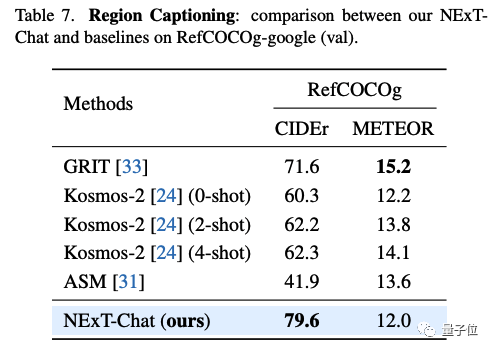
在区域描述任务上,NExT-Chat也能取得最优的CIDEr表现,且在该指标打败了4-shot情况下的Kosmos-2。
那么,NExT-Chat背后都采用了哪些方法呢?
 Scenari
 o
一个AI生成游戏资产的工具
 56
查看详情

传统的模型主要通过pix2seq的方式进行LLM相关的位置建模。
比如Kosmos-2将图像划分成32x32的区块,用每个区块的id来代表点的坐标;Shikra将物体框的坐标转化为纯文本的形式从而使得LLM可以理解坐标。
但使用pix2seq方法的模型输出主要局限在框和点这样的简单格式,而很难泛化到其他更密集的位置表示格式,比如segmentation mask。
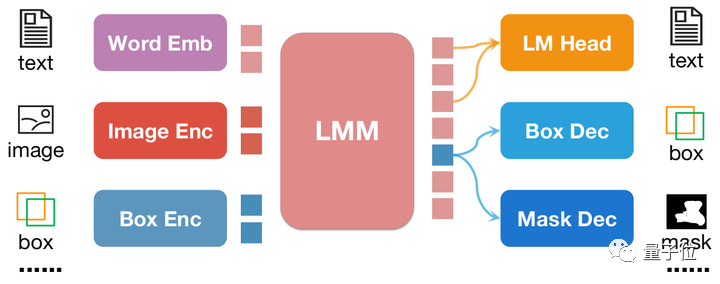
为了解决这个问题,本文提出了一种全新的基于embedding的位置建模方式pix2emb。
不同于pix2seq,pix2emb所有的位置信息都通过对应的encoder和decoder进行编码和解码,而不是借助LLM本身的文字预测头。
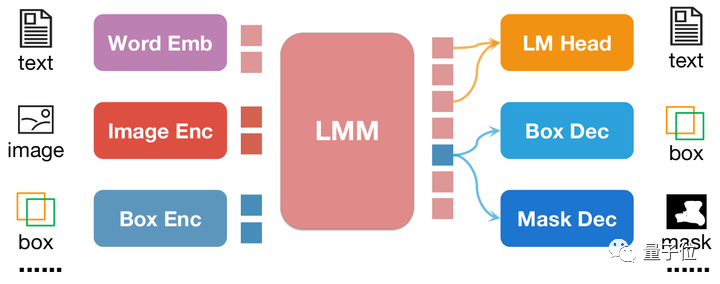
如上图所示,位置输入被对应的encoder编码为位置embedding,而输出的位置embedding则通过Box Decoder和Mask Decoder转化为框和掩模。
这样做带来了两个好处:
通过将pix2seq与pix2emb结合,作者训练了全新的NExT-Chat模型。
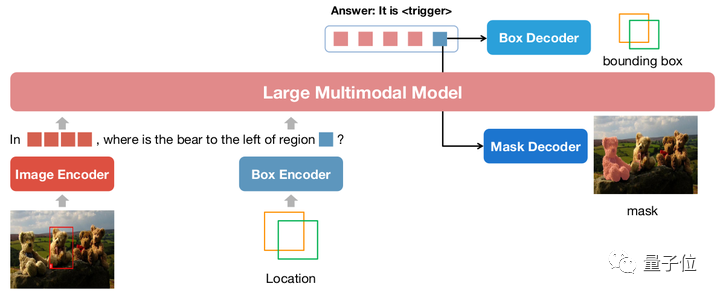
NExT-Chat整体采用了LLaVA架构,即通过Image Encoder来编码图像信息并输入LLM进行理解,并在此基础上添加了对应的Box Encoder和两种位置输出的Decoder。
为了解决LLM不知道何时该使用语言的LM head还是位置解码器的问题,NExT-Chat额外引入一个全新的token类型来标识位置信息。
如果模型输出了,则该token的embedding会被送入对应的位置解码器进行解码而不是语言解码器。
此外,为了维持输入阶段和输出阶段位置信息的一致性,NExT-Chat额外引入了一个对齐约束:
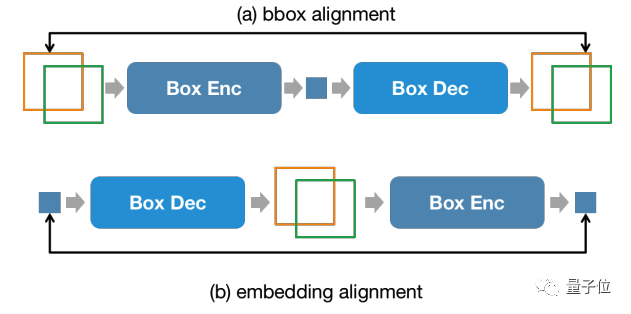
如上图所示,box和位置embedding会被分别通过解码器、编码器或解码器编码器组合,并要求前后不发生变化。
作者发现该方法可以极大程度促进位置输入能力的收敛。
而NExT-Chat的模型训练主要包括3个阶段:
这样的训练流程的好处在于:检测框数据丰富且训练开销更小。
NExT-Chat通过在充沛的检测框数据训练基本的位置建模能力,之后可以快速的扩展到难度更大且标注更稀缺的分割任务上。
以上就是大规模模型已经可以为图像做标注,只需简单对话!清华&NUS的研究成果的详细内容,更多请关注其它相关文章!
# AI
# 郑州整站网站优化平台
# 丹东seo入门公司推荐
# 建设网站的华丽语言
# 用了
# 只需
# 也能
# 多个
# 扩展到
# 出了
# 玩家们
# 所示
# 多模
# 清华
# 模型
# 蓟县餐饮网站建设
# 营销推广都铎火星
# 附近的seo方案
# 电器营销推广文案素材库
# 搜索关键词排名靠谱
# 绵阳seo优化
# ai seo工具
相关栏目:
【
Google疑问12 】
【
Facebook疑问10 】
【
优化推广96088 】
【
技术知识133117 】
【
IDC资讯59369 】
【
网络运营7196 】
【
IT资讯61894 】
相关推荐:
科技数码圈的新物种 乐天派桌面机器人 AI +安卓+机器人 首发价1799元
跟着AI大热的“光模块”到底是什么?
亚马逊确认今年不举办re:MARS人工智能大会
美图秀秀发布7款AI产品:支持用户创作、商业创作
美图设计室2.0什么时候上线
日媒:AI高效解析纳斯卡地画
如布AI口袋学习机S12 将亮相综艺节目《好样的!国货》
衡水市冀州中学机器人社团在世界机器人大赛中斩获佳绩
美妆行业在AI时代蓬勃发展
大疆 Air 3 无人机售价和实物照片曝光
彭博社:苹果Vision Pro曾测试VR手柄追踪方案
超级智能到底是什么?
“五年内人类程序员将消失”预言引争议,AI真的那么强大了吗?
电池比 Air 2S 大 20%,大疆 Air 3 无人机现身 FCC
扎克伯格吐槽苹果Vision Pro:社交落后Meta太多,无法建设元宇宙
研究发现AI聊天机器人ChatGPT不会讲笑话,只会重复25个老梗
WAIC 2025|云深处科技绝影Lite3与X20四足机器人亮相
人形机器人概念集体爆发,能买吗?
洞穴探险神器?可自主导航的单旋翼自旋无人机,效率更高!
五个IntelliJ IDEA插件,高效编写代码
人工智能助力林草行业高质量发展
360发布AI数字人广场,可同孙悟空、爱因斯坦等古今中外角色对话
水路两栖艇、消防灭火机器人……这个展览“黑科技”抢眼
马斯克“揭秘”人工智能真面目
“无人驾驶船”将首次亮相世界人工智能大会,下半年或开进上海迪士尼
南京制造的国产工业机器人:在外资品牌竞争中突围,年销售1.8万台
生成式AI爆发,亚马逊云科技持续专注创新,助力企业数字化转型
2025智源大会AI安全话题备受关注,《人机对齐》新书首发
AI生成新闻网站数量激增,正在疯狂赚取广告收入
北京公司实施AI技术,推行4.5天工作制,抵制996文化,提升员工工作幸福感
人工智能驱动艺术,打开达利的超现实想象
小米发布CyberDog2 - 他们的第二代仿生四足机器人展示
微软为 AI 初学者推出免费网课:为期 12 周,共 24 节课
6月14日《星空下的对话》 张朝阳陆川将畅聊人生、电影、心理学与AI
马斯克回应“人工智能让一切变得更好”:我们已经是半机器人了
食品分销跨国企业Sysco CIDO:我们的增长秘诀是以IT为中心
深度学习模型综述:用于3D MRI和CT扫描的应用
VMS的应用:提升多品牌设备管理效能
OpenAI CEO 阿尔特曼到访日本,对全球 AI 协调合作表示乐观
650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了
苹果AR头显商标与华为撞车,在中国或改名
周星驰支持的人工智能与 Web3 初创公司 Moonbox 完成 100 万美元融资
东软成立魔形科技研究院,积极布局大语言模型系统工程战略,迎接AI时代
值得买科技入选“北京市通用人工智能产业创新伙伴计划”应用伙伴
IBM CEO克里希纳:人工智能潜在创新无法被监管
如布科技发布新产品AI口袋学习机S12
报道称亚马逊正在测试AI生成产品评价摘要
杭州举办第19届亚运会,主题为「亚运元宇宙」的发布仪式举行
“可用”“有用”的讯飞星火认知大模型将亮相世界人工智能大会
AI赋能艺术 超现实达利奇幻之旅在沪开启
2024-01-05

运城市盐湖区信雨科技有限公司是一家深耕海外推广领域十年的专业服务商,作为谷歌推广与Facebook广告全球合作伙伴,聚焦外贸企业出海痛点,以数字化营销为核心,提供一站式海外营销解决方案。公司凭借十年行业沉淀与平台官方资源加持,打破传统外贸获客壁垒,助力企业高效开拓全球市场,成为中小企业出海的可靠合作伙伴。
